Una cámara o un sensor produce mediciones, no necesariamente cada coordenada de la señal. Con menos mediciones que incógnitas suele haber muchas respuestas. Veremos qué cambia si sabemos que solo unas pocas coordenadas son distintas de cero y por qué resolver una optimización no garantiza, por sí solo, recuperar la señal verdadera.
Si necesitas repasar:
1. Las mediciones mezclan coordenadas y pueden perder información
Entonces x y x+h producen la misma y. Sin una restricción adicional no se recupera cualquier vector de forma única.
Llamamos s-dispersa a una señal con como máximo s coordenadas no nulas. La restricción se refiere a una representación concreta: una señal puede ser dispersa en una base y no en otra. Si x=Bc y c es disperso, la matriz que mide sus coeficientes es AB.
Tres coordenadas, dos medidas
A tiene filas (1,0,1) y (0,1,1).
Leer
y₁=x₁+x₃; y₂=x₂+x₃.Relación
Las columnas son (1,0), (0,1), (1,1). La tercera suma las dos primeras.
Ambigüedad
x=(1,1,0) y z=(0,0,1) producen y=(1,1).
Las mediciones no distinguen estas señales arbitrarias.
Una tiene dos no nulos y la otra uno: la clase admisible importa.
Una sola medición repetida
A=(1,1).
Medir
(1,0) produce uno.
Otra señal
(0,1) también produce uno.
Restricción
Ambas son uno-dispersas: esa matriz falla incluso en esta clase.
Pedir dispersión no arregla cualquier diseño de medición.
El número de medidas solo no describe la geometría de A.
2. Contar coordenadas no nulas y sumar amplitudes son objetivos distintos
La notación  cuenta coordenadas no nulas. No es una norma: multiplicar un vector por dos no duplica ese conteo. La norma
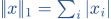 sí suma amplitudes absolutas y es convexa.
Una señal aproximadamente dispersa tiene una cola pequeña.  es el error de la mejor aproximación s-dispersa en ℓ¹: se conservan s coordenadas de mayor módulo y se suma el módulo de las restantes.
Mismo soporte, amplitudes distintas
x=(0,2,0,−3) y 2x=(0,4,0,−6).
Conteo
Ambos tienen dos coordenadas no nulas.
Amplitud
Sus normas ℓ¹ son cinco y diez.
Conclusión
El conteo no es homogéneo como exige una norma.
ℓ⁰ y ℓ¹ no se intercambian solo por parecerse sus símbolos.
Los signos negativos también cuentan como coordenadas no nulas.
Medir la cola
x=(4,1,1/10,−1/20), s=2.
Ordenar módulos
Cuatro y uno son los dos mayores.
Aproximar
Conservamos (4,1,0,0).
Error
σ₂(x)₁=1/10+1/20=3/20.
x no es exactamente dos-dispersa, pero su cola es pequeña.
No redondeamos coordenadas a cero sin declarar qué error aceptamos.
3. El núcleo decide si las señales dispersas se pueden distinguir
Dos señales s-dispersas difieren en como máximo 2s posiciones. Por eso no debe existir un h≠0 del núcleo con a lo sumo 2s no nulos. Esta condición garantiza unicidad para todas las señales de esa clase.
También es necesaria: se divide el soporte de tal h en S y T con a lo sumo s posiciones cada una. Las señales  y −
 son distintas, s-dispersas y tienen la misma medición. Se escribe spark(A)>2s, donde spark es el soporte mínimo de un vector no nulo del núcleo.
Una matriz que distingue todas las señales uno-dispersas
Para la A de dos filas anterior, ker A={t(−1,−1,1)}.
Resolver
h₁+h₃=0 y h₂+h₃=0.Contar
Si t≠0, las tres coordenadas son no nulas: spark=3.
Comparar
3>2·1: todas las señales uno-dispersas se distinguen.
No contradice la ambigüedad entre (1,1,0) y (0,0,1).
La primera señal de esa pareja no es uno-dispersa.
Construir dos señales indistinguibles
A=(1,1) y h=(1,−1) está en el núcleo.
Dividir
S={1}, T={2}.Señales
=(1,0); −=(0,1).Medir
Ambas dan uno. El soporte de h tiene tamaño dos.
Aquí spark=2 y falla la condición estricta para s=1.
La igualdad spark=2s no basta.
4. Minimizar ℓ¹ facilita el cálculo, pero cambia el problema
Basis pursuit sustituye el objetivo por ℓ¹. En el caso real se formula como programa lineal: minimizar la suma de  con −≤
 ≤ y Az=y. Es un problema convexo.
Convexo significa que optimizamos eficazmente el objetivo elegido bajo condiciones habituales del algoritmo. No demuestra que ese objetivo seleccione la señal verdadera. Puede haber empates o preferir una señal diferente. Hay que estudiar A, no solo el método de cálculo.
Un empate
A=(1,1), y=1 y z=(t,1−t).
Entre cero y uno
Ambas coordenadas son no negativas.
Norma
|t|+|1−t|=1 para todo 0≤t≤1.Conclusión
(1,0), (0,1) y todos esos puntos minimizan ℓ¹.
No hay un único minimizador que revele cuál se envió.
Muchos de los minimizadores ni siquiera son uno-dispersos.
Una preferencia equivocada
A=(1,2), y=1 y señal verdadera x=(1,0).
Verdadera
Tiene una coordenada no nula y norma ℓ¹ igual a uno.
Alternativa
z=(0,1/2) también mide uno, es uno-dispersa y tiene norma 1/2.
Elegir
ℓ¹ prefiere la alternativa: recuperar exactamente el mínimo no recupera x.
La escala y la geometría de las columnas importan.
Normalizar columnas cambia los coeficientes y debe reflejarse en el modelo.
5. La propiedad del núcleo caracteriza la recuperación uniforme por ℓ¹
NSP de orden s exige, para todo h≠0 en ker A y todo S con |S|≤s, 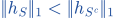 . La parte invisible de la medición no puede concentrar la mitad o más de su amplitud en un soporte admisible.
 .
Así x es el mínimo único. Si NSP falla, x=− y z=ᶜ miden igual y z no cuesta más: tampoco hay recuperación uniforme única.
Comprobar NSP de orden uno
ker A={t(−1,−1,1)} en la matriz de dos mediciones.
Una posición
Para cualquier t≠0, su módulo aporta |t|.Las otras dos
Aportan 2|t|.
Estricto
|t|<2|t|; también se cumple para S vacío.NSP de orden uno queda probada.
Toda señal uno-dispersa se recupera por ℓ¹ con esta A.
No basta probarlo para un vector aislado si el núcleo tiene más direcciones.
Ver un mínimo concreto
x=(1,0,0). Toda señal con su medida es z=(1−t,−t,t).
Objetivo
‖z‖₁=|1−t|+2|t|.Cota
|1−t|≥1−|t|, luego ‖z‖₁≥1+|t|.Único
Si t≠0 el coste supera uno; t=0 recupera x.
La desigualdad muestra unicidad sin dibujar infinitas candidatas.
El signo del parámetro no afecta al argumento.
6. RIP conserva longitudes de señales dispersas y da garantías suficientes
RIP de orden k exige 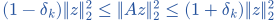 para todo z k-disperso. Una condición clásica suficiente para recuperación estable por ℓ¹ es δ₂ₛ<√2−1. No es necesaria ni la mejor constante de todas las variantes.
La coherencia compara productos de columnas normalizadas: columnas idénticas no distinguen qué coordenada actuó. Ciertas familias aleatorias dan garantías con alta probabilidad y tamaños de orden s·log(N/s), con condiciones y constantes propias. No toda matriz de esas dimensiones tiene la garantía.
Columnas duplicadas
Las dos columnas de A=(1,1) coinciden.
Diferencia
z=(1,−1) tiene dos no nulos y Az=0.RIP inferior
Con δ₂<1, exigiría 0≥(1−δ₂)·2>0.Imposible
No puede cumplir una RIP de orden dos con constante menor que uno.
La pérdida de una dirección dispersa impide una cota inferior positiva.
Un buen ajuste de mediciones no distingue esa dirección.
Una garantía suficiente no es necesaria
La matriz de dos filas recupera todas las señales uno-dispersas por NSP.
Elegir
z=(1,0,1) tiene norma al cuadrado dos.Medir
Az=(2,1), con norma al cuadrado cinco.RIP
La cota superior exigiría 5≤2(1+δ₂), luego δ₂≥3/2.Falla la condición clásica, aunque NSP sí vale.
No cumplir esa cota RIP no demuestra que ℓ¹ falle.
El cálculo usa la matriz tal como está, sin normalizar columnas.
7. Con ruido hay dos fuentes distintas de error
Si y=Ax+e y ‖e‖₂≤ε, sustituimos la igualdad por una tolerancia: minimizar ‖z‖₁ sujeto a ‖Az−y‖₂≤ε. Bajo la condición RIP suficiente indicada, 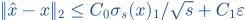 . Las constantes dependen del operador y de su garantía.
La cola mide falta de dispersión exacta; ε mide ruido de medición. La tolerancia debe contener el error real y usar las mismas unidades. Una respuesta con residual pequeño no asegura poco error de señal si la matriz pierde información.
Leer los dos términos
s=4, cola σ₄(x)₁=0,2 y ruido ε=0,01.
Aproximación
σ₄/√4=0,1.Cota
El error queda acotado por 0,1C₀+0,01C₁ si se cumplen las hipótesis.
No inventar
Sin fijar A y sus constantes no damos un número certificado.
La fórmula separa dos causas, no identifica el error exacto.
Si la señal es exactamente dispersa, solo desaparece el primer término.
Una tolerancia demasiado pequeña
x=(1,0,0), la A de dos filas y ruido e=(0; 0,1).
Dimensiones
El ruido tiene dos coordenadas: cero y una décima.
Medición
y=(1; 0,1), por tanto ‖Ax−y‖₂=0,1.Elegir ε=0,05
La señal verdadera ni siquiera es factible.
La garantía no se aplica con una tolerancia que excluye la verdad.
El punto y coma evita confundir coma decimal con separador de coordenadas.
8. El umbral suave resuelve una penalización concreta
LASSO en esta forma minimiza 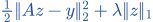 , con λ>0. Un paso proximal toma v=z−αAᵀ(Az−y) y aplica
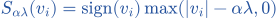 a cada coordenada.
Un tamaño 0<α≤1/‖A‖₂² es una elección estándar para el descenso proximal cuando A≠0. El algoritmo reduce amplitudes y puede anular pequeñas coordenadas. Su convergencia optimiza la penalización; no demuestra NSP ni convierte el sesgo del umbral en mediciones exactas.
Primeros pasos escalares
A=1, y=3, λ=1, α=1/2 y z₀=0.
Paso uno
v=0−(1/2)(0−3)=1,5.Umbral 0,5: z₁=1.Paso dos
v=1−(1/2)(1−3)=2.Umbral 0,5: z₂=1,5.Límite
El mínimo es z=2: el umbral introduce sesgo respecto a y=3.
Este caso de una coordenada enseña el algoritmo; no es un ejemplo de compresión.
No confundimos solución penalizada con resolver Az=y.
Aplicar el umbral a signos distintos
Umbral τ=1 sobre (3,−2,1,−1/2).
Positivo grande
Tres pasa a dos.
Negativo grande
Menos dos pasa a menos uno: se reduce el módulo.
Pequeños
Uno y menos un medio pasan a cero.
Resultado (2,−1,0,0).
El umbral suave resta al módulo, no convierte todo valor grande en uno.
Ahora lo resolvemos de principio a fin.
EJEMPLO RESUELTO 1
Contar dispersión
Para x=(0,3,0,−2,0), calcula ||x||₀ y ||x||₁.
Vector
x=(0,3,0,−2,0).Soporte
Solo las posiciones segunda y cuarta son no nulas.
Conteo
‖x‖₀=2.Módulos
0,3,0,2,0.
Sumar
‖x‖₁=3+2=5.Comprobar
Un signo negativo no elimina una coordenada del conteo ni resta amplitud.
||x||₀=2 y ||x||₁=5.
La primera cuenta; la segunda mide amplitud total.
EJEMPLO RESUELTO 2
Medición ambigua
Con A=[1,1], muestra dos señales de una componente no nula con medida 1.
Matriz
A=(1,1) transforma (a,b) en a+b.Primera
x=(1,0) tiene una componente no nula y Ax=1.Segunda
z=(0,1) tiene una componente no nula y Az=1.Distintas
x≠z aunque ambas mediciones sean uno.Núcleo
x−z=(1,−1) y A(x−z)=0.Conclusión
La recuperación única falla incluso entre señales uno-dispersas; sus normas ℓ¹ también empatan.
La recuperación única falla.
La diferencia (1,−1) está en el núcleo.
Los símbolos que hemos usado
- s-dispersa
- Señal con a lo sumo s componentes no nulas.
- ‖x‖₀
- Número de componentes no nulas; no es una norma.
- ‖x‖₁
- Suma de módulos de las componentes.
- ker A
- Vectores que producen medición cero.
- NSP
- Propiedad del núcleo que garantiza recuperación uniforme por ℓ¹.
- RIP
- Preservación aproximada de norma sobre vectores de dispersión acotada.
- σ_s(x)₁
- Error de la mejor aproximación s-dispersa en normaℓ¹.
Ahora te toca a ti.
Tienes cinco ejercicios. Inténtalos; las pistas te ayudan si te atascas.
Practicar este tema →