Tener más variables que observaciones cambia el problema: distintos coeficientes pueden explicar exactamente los mismos datos. Veremos qué restricción añade Lasso, por qué crea ceros y qué condiciones hacen falta para pasar de un buen ajuste a una afirmación estadística.
Si necesitas repasar:
1. Más coeficientes que datos deja direcciones que no se observan
Los coeficientes β y β+h producen la misma predicción. Sin otra restricción, ni siquiera datos sin ruido distinguen todas las coordenadas.
Dispersión significa que β tiene pocas entradas no nulas. También necesitamos un diseño que distinga esas direcciones relevantes. Alta dimensión no hace imposible toda predicción; obliga a precisar qué objeto está identificado y qué estructura asumimos.
Una observación y dos coeficientes
X=(1,1), y=3 y ruido cero.
Una ecuación
β₁+β₂=3.Varias respuestas
(3,0), (0,3) y (1,2) producen el mismo dato.
Núcleo
h=(1,−1) deja Xβ sin cambio.
El dato identifica la suma, no cada coeficiente.
Incluso las dos soluciones con una sola entrada no nula son indistinguibles.
Una señal dispersa necesita columnas distinguibles
Dos columnas son idénticas a un vector x no nulo.
Señales
β=(a,0) y γ=(0,a) son ambas dispersas.Predicciones
Xβ=ax=Xγ.Conclusión
La dispersión sola no identifica cuál variable porta el coeficiente.
Hace falta una condición del diseño además de contar ceros.
Una predicción puede ser igual con soportes diferentes.
2. Lasso fija una convención de pérdida y penaliza la suma de módulos
Usamos 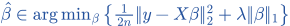 , con λ>0. La norma L¹ suma |βⱼ|. La penalización tiene esquinas que permiten ceros exactos. En dimensión finita hay un mínimo por continuidad y coercividad de la penalización.
Los coeficientes no siempre son únicos con columnas degeneradas, aunque la predicción ajustada sí es única para esta pérdida cuadrática convexa: dos predicciones distintas promediarían a una pérdida estrictamente menor. Cambiar la escala 1/(2n) o las unidades de columnas cambia el significado numérico de λ; se declara la estandarización.
Calcular una penalización
β=(3,−4,0), λ=2.
Módulos
|3|+|−4|+|0|=7.Penalización
λ||β||₁=2·7=14.Distinción
El coste total también incluye el ajuste cuadrático a los datos.
La norma L¹ no permite que el signo menos cancele el tres.
La suma algebraica sería −1 y no es la penalización.
Las unidades alteran qué coeficiente se penaliza
Una columna x se sustituye por 10x para mantener la misma predicción.
Coeficiente
El coeficiente equivalente pasa de β a β/10.
Mismo ajuste
xβ=(10x)(β/10).Otro coste
Su contribución L¹ se divide por diez con λ fijo.
Escalar columnas puede cambiar la preferencia de Lasso.
Estandarizar debe formar parte del procedimiento, no quedar oculto.
3. El problema escalar se resuelve en tres regiones
Juntando: 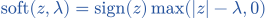 . La pérdida total es estrictamente convexa, así que el óptimo escalar es único, también en el umbral.
Un dato por encima del umbral
z=6 y λ=2.
Región
6>2, así el óptimo es positivo.Despejar
b=6−2=4.Verificar
Q′(4)=4−6+2=0.
La penalización reduce el módulo en dos.
No divide el dato por dos.
Un dato dentro de la zona nula
z=−1 y λ=2.
Región
|z|=1≤2.Subgradiente
−z=1 puede cancelarse con 2s tomando s=−1/2∈[−1,1].Óptimo
b=0.
La esquina permite anular exactamente el coeficiente.
En z=−2 el óptimo también es cero.
4. La solución coordenada a coordenada exige ortogonalidad
Si XᵀX/n=I, expandir la pérdida deja, salvo constante, Σ[(βⱼ−zⱼ)²/2+λ|βⱼ|], con z=Xᵀy/n.
Es una simplificación por diseño, no una fórmula general para columnas correlacionadas.
Con p>n, todas las p columnas no pueden ser ortonormales. En un diseño general se usan residuos parciales, métodos de coordenadas o pasos proximales. La geometría de la bola L¹ ayuda a entender los ceros, pero no elimina los términos cruzados de la pérdida.
Un caso ortogonal con dos entradas
z=(3,1/2), λ=1 y XᵀX/n=I.
Primera
soft(3,1)=2.Segunda
soft(1/2,1)=0.Resultado
β̂=(2,0), con norma L¹ dos.
La figura muestra ese óptimo en una esquina.
La correspondencia con una restricción L¹ de radio dos pertenece a este ejemplo concreto.
Detectar que una fórmula separada ya no es válida
La matriz de Gram tiene filas (1,ρ) y (ρ,1), con ρ≠0.
Pérdida
El término cuadrático incluye ρβ₁β₂.
Dependencia
Cambiar β₁ altera la ecuación óptima de β₂.
Conclusión
No se minimizan dos problemas independientes con los z originales.
Una actualización por coordenadas debe usar el residuo que dejan las otras.
Si ρ=0, el acoplamiento desaparece.
5. El residuo óptimo satisface una correlación que podemos comprobar
Las condiciones convexas necesarias y suficientes son  , con sⱼ=sign β̂ⱼ si β̂ⱼ≠0 y |sⱼ|≤1 si β̂ⱼ=0. Una coordenada nula puede ser óptima porque su correlación residual queda dentro de ese intervalo.
Un cero seleccionado no demuestra irrelevancia causal ni coeficiente verdadero cero. Con columnas idénticas, repartir una suma positiva entre ellas puede dejar la misma predicción y el mismo coste L¹. Las condiciones óptimas explican ese empate sin exigir una unicidad inexistente.
Comprobar dos coordenadas en el caso ortogonal
z=(3,1/2), λ=1 y β̂=(2,0).
Correlación residual
Como Gram=I, z−β̂=(1,1/2).Activa
La primera coordenada cumple uno=λsign(2).Nula
La segunda cumple |1/2|≤λ.
Ambas condiciones certifican el óptimo.
No se obliga a que una coordenada nula tenga correlación residual exactamente cero.
Un continuo de coeficientes óptimos
X=(1,1), n=1, y=3 y λ=1.
Suma
Para una suma c≥0, el coste mínimo L¹ posible es c.
Óptimo de c
soft(3,1)=2.Repartos
Cualquier β₁,β₂≥0 con β₁+β₂=2 es óptimo.
La predicción dos es única; los dos coeficientes no lo son.
El mismo residuo uno satisface ambas condiciones con subgradientes admisibles.
6. Una cota estadística necesita controlar el ruido y un cono de direcciones
La desigualdad básica de optimalidad y λ≥2||Xᵀε/n||∞ dan  . Como el primer término es no negativo, el error pertenece al cono ||ΔSc||₁≤3||ΔS||₁.
Supongamos además el autovalor restringido ||XΔ||²/n≥κ||Δ||² para ese cono, con κ>0.
Son cotas bajo un evento de ruido y una geometría especificados; no garantizan recuperación en cualquier matriz.
Saber por qué falla la geometría con columnas duplicadas
S={1}, h=(1,−1) y columnas uno y dos idénticas.
Cono
||hSc||₁=1≤3||hS||₁=3.Diseño
Xh=0 aunque ||h||₂²=2.Fallo
No existe κ>0 que dé 0≥κ·2 en esa dirección.
La hipótesis restringida excluye precisamente una ambigüedad relevante.
No basta que cada columna tenga norma positiva.
Una escala de ruido con hipótesis explícitas
Diseño fijo con ||Xⱼ||²/n≤1 y ε∼N(0,σ²I).
Una coordenada
Xⱼᵀε/n es normal de varianza como máximo σ²/n.
Muchas coordenadas
Una cota de colas normal y unión sobre p columnas controla su máximo por σ√(2log(2p/δ)/n), con probabilidad al menos 1−δ.
Elegir
Dos veces esa cota es una elección suficiente de λ para el evento usado arriba.
La regla depende de σ, normalización, p y tolerancia δ∈(0,1).
No equivale automáticamente al λ elegido por validación predictiva.
7. Predecir, seleccionar e inferir tienen criterios de éxito diferentes
Predecir compara respuestas o Xβ; seleccionar busca qué coeficientes son no nulos; inferir pretende intervalos o pruebas para un objetivo declarado. Una predicción buena no garantiza soporte exacto ni cobertura correcta de un intervalo.
Recuperación exacta del soporte suele necesitar señal mínima y condiciones adicionales de diseño. La penalización introduce sesgo. Seleccionar y luego aplicar fórmulas ordinarias como si el modelo estuviera fijado de antemano puede invalidar la inferencia. El error dentro del diseño tampoco garantiza por sí solo buen rendimiento en una población nueva.
Predecir igual con soportes opuestos
Dos columnas duplicadas y soluciones (2,0) y (0,2).
Predicción
Las dos dan la misma respuesta ajustada.
Selección
Una elige la primera variable y otra la segunda.
Interpretación
La igualdad predictiva no decide cuál soporte es verdadero.
La diferencia entre objetivos no es una cuestión de presentación.
Tampoco se deduce causalidad de cuál columna haya elegido un algoritmo.
Un cero no prueba una hipótesis estadística
Una señal escalar observada z=0,9 y umbral λ=1.
Algoritmo
soft(0,9;1)=0.Estadística
Para probar un coeficiente verdadero necesitamos la ley del dato y un nivel de error.
Fallo de inferencia automática
El cálculo del umbral no proporciona por sí solo un valor p ni un intervalo.
La selección es una decisión de estimación, no una prueba ya calibrada.
La ley bajo hipótesis nula debe formar parte de la justificación.
8. Desesgar requiere controlar el resto de una identidad exacta
Con Gram G=XᵀX/n y una matriz auxiliar M, definimos β̃=β̂+MXᵀ(y−Xβ̂)/n. La descomposición exacta es 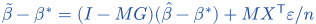 . El segundo término es gaussiano condicionado en un diseño fijo si M depende solo de X y el ruido es gaussiano.
El resto de la coordenada j se acota por ||(I−MG)ⱼ·||∞||β̂−β*||₁. Con ε∼N(0,σ²I) y M dependiente solo de X, la varianza condicional del término de ruido j es 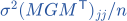 . Para inferir, el resto debe ser despreciable respecto de esa escala de ruido, no solo pequeño sin escala.
Con M aleatoria dependiente también de y, la normalidad condicional no se afirma mediante el mismo argumento. Inferencia selectiva o separación de muestras tienen otros marcos propios.
Una comprobación en el caso ortogonal
G=I y M=I.
Resto
I−MG=0.Corregir
β̃=β̂+Xᵀy/n−β̂=Xᵀy/n.Resultado
Se recupera el estimador no penalizado z, eliminando el sesgo del umbral en este diseño.
La corrección puede perder ceros y aumentar variación.
No se ha demostrado que M=I funcione en un diseño general.
Un resto pequeño necesita compararse con su error estándar
Error estándar de orden n⁻¹ᐟ²; resto de orden n⁻¹ᐟ⁴.
Sin escala
El resto tiende a cero.
Comparar
Su cociente con n⁻¹ᐟ² tiene orden n¹ᐟ⁴.
Inferencia
No es despreciable a la escala requerida para una normal centrada.
Corregir algo de sesgo no demuestra una expansión inferencial válida.
También hacen falta control de la varianza y sus estimaciones.
9. La multiplicidad y la población de destino se declaran antes de interpretar resultados
Probar muchas coordenadas añade el problema de falsos positivos múltiples. Incluso intervalos marginales válidos no forman automáticamente una cobertura simultánea para todos los coeficientes. La selección, el nivel y el conjunto de hipótesis evaluadas deben quedar definidos.
Al predecir fuera de la muestra, importa la relación entre diseño observado y distribución futura. Una dirección que no varía en entrenamiento puede variar después. La calidad de un ajuste, la identificación de un coeficiente y el comportamiento fuera de muestra requieren comprobaciones distintas.
Muchas pruebas de nivel marginal
Cien pruebas, cada una con probabilidad de falso positivo como máximo 0,05 bajo su nula.
Cota global
La unión da una cota máxima cien por 0,05, que se trunca en uno y no asegura un 5 % global.
Bonferroni
Un nivel 0,05/100=0,0005 por prueba controla la probabilidad de al menos un falso positivo por 0,05.
Alcance
No se exige independencia para esa cota de unión.
La calibración marginal y la familiar son diferentes.
La selección previa también debe incorporarse al procedimiento usado.
Iguales en entrenamiento, distintas fuera
Dos columnas fueron idénticas en los datos observados y difieren en la nueva población.
Dentro
No se distinguían β=(2,0) y γ=(0,2).Fuera
Si las nuevas covariables son (1,0), las predicciones son dos y cero.
Conclusión
La equivalencia del ajuste observado no garantiza equivalencia predictiva en ese cambio de población.
El contexto de uso forma parte de la evaluación.
La penalización no crea los datos faltantes en una dirección nunca observada.
Ahora lo resolvemos de principio a fin.
EJEMPLO RESUELTO 1
Umbral positivo
Calcula soft(5,2).
Definición
soft(z,λ)=sign(z)max(|z|−λ,0).Datos
z=5 y λ=2.Módulo
|5|−2=3.Máximo
max(3,0)=3.Signo
sign(5)=1, así el resultado es tres.Comprobar
El óptimo positivo cumple b−5+2=0, que da b=3.
El coeficiente es 3.
La penalización reduce el valor original en 2.
EJEMPLO RESUELTO 2
Anulación
Calcula soft(−1,3).
Datos
z=−1 y λ=3.Tamaño
|−1|=1, menor que tres.Restar
|z|−λ=1−3=−2.Máximo
max(−2,0)=0.Resultado
El coeficiente queda en cero.
Comprobar
La correlación escalar |z|≤λ cumple la condición subgradiente en cero.
El coeficiente queda anulado.
El umbral supera el tamaño observado.
Los símbolos que hemos usado
- n / p
- Número de observaciones / número de coeficientes del modelo.
- X
- Matriz de diseño de tamaño n×p.
- β
- Vector de coeficientes; β* denota un valor verdadero cuando se supone ese modelo.
- Dispersión s
- Número de coeficientes no nulos, o estructura aproximadamente dispersa declarada.
- ‖β‖₁
- Suma de los valores absolutos de sus componentes.
- λ≥0
- Intensidad de la penalización, dependiente de la normalización de la pérdida.
- Subgradiente
- Pendiente generalizada de una función convexa; para |b| en cero es [−1,1].
- Soporte
- Conjunto de índices de coeficientes no nulos.
Ahora te toca a ti.
Tienes cinco ejercicios. Inténtalos; las pistas te ayudan si te atascas.
Practicar este tema →