La media es un centro ponderado; la varianza mide cuánto nos alejamos de ese centro; la covarianza compara dos desviaciones a la vez. Haremos las cuentas desde su definición antes de usar las fórmulas abreviadas. También veremos cuándo estos números no existen o no bastan para describir una relación.
Si necesitas repasar:
1. La esperanza pesa cada valor por la probabilidad con que aparece
Para una ley discreta, EX=Σx p(x); con densidad, EX=∫x f(x)dx. En general es la integral de X respecto a P. Una esperanza real finita exige E|X|<∞: no se restan dos infinitos esperando que se cancelen.
Para X≥0, la esperanza puede valer +∞ sin ambigüedad. Para una variable con partes positiva y negativa de esperanza infinita, la esperanza no está definida. Una integral simétrica o un dibujo centrado no sustituye ese requisito.
Una media no es el punto medio de los extremos
X toma 0,2,5 con probabilidades 0,2;0,5;0,3.
Contribuciones
0·0,2=0;2·0,5=1;5·0,3=1,5.Sumar
EX=0+1+1,5=2,5.Interpretar
La media pondera las frecuencias del modelo, no solo los valores extremos.
EX=2,5.
Las probabilidades suman uno; un promedio sin ponderar de los tres valores respondería otra pregunta.
Infinita y no definida son situaciones distintas
Compara una variable positiva de valores 2ⁿ con masas 2^(−n), n≥1, y una Cauchy estándar.
Positiva
Cada término de EX es 2ⁿ2^(−n)=1; la suma vale +∞.Cauchy
Su densidad es 1/[π(1+x²)]; la integral positiva de x diverge como ln(1+x²). La negativa también tiene magnitud infinita.
Conclusión
La primera tiene esperanza extendida +∞; la segunda no tiene esperanza, ni siquiera cero por simetría.
No se interpreta ∞−∞ como cero.
El valor principal simétrico de una integral de Cauchy es otra noción, no su esperanza probabilística.
2. La media de una suma es lineal aunque las variables dependan
Se deduce de la linealidad de la integral y no requiere independencia. Calcular productos y varianzas será una cuestión distinta.
Para h convexa, Jensen da h(EX)≤E[h(X)] bajo las condiciones adecuadas. Una forma de verlo, si existe una recta de apoyo en μ=EX, es h(x)≥h(μ)+m(x−μ): al promediar, el último término desaparece.
Una variable determinada por la otra no impide sumar medias
EX=3, Y=2X+1.
Media de Y
EY=2·3+1=7.Suma
E(X+Y)=3+7=10.Comprobación directa
X+Y=3X+1, cuya esperanza también es 10.
La respuesta no necesita independencia.
Y depende completamente de X, pero la linealidad de la suma sigue siendo válida.
Elevar al cuadrado antes o después cambia el resultado
X toma −2 y 2 con igual probabilidad.
Media
EX=0.Cuadrados
X²=4 siempre, así E(X²)=4.Comparar
(EX)²=0≤4=E(X²).
No se intercambia el cuadrado con la esperanza.
La diferencia entre esos dos números será precisamente la varianza en este ejemplo.
3. La varianza empieza restando la media y después elevando al cuadrado
Es no negativa.
La finitud del segundo momento garantiza además integrabilidad de X por Cauchy–Schwarz.
Si Var(X)=0, el cuadrado no negativo vale cero casi seguramente: X=μ casi seguramente. No se exige igualdad en cada resultado de un espacio que pueda contener sucesos nulos. Para variables sin momentos finitos, no se aplica una resta de infinitos.
Calcular por dos caminos permite comprobar
X de valores 0,2,5 y masas 0,2;0,5;0,3; media 2,5.
Momento segundo
E(X²)=0·0,2+4·0,5+25·0,3=9,5.Restar el cuadrado de la media
Var(X)=9,5−6,25=3,25.Desde el centro
0,2·(−2,5)²+0,5·(−0,5)²+0,3·2,5²=3,25.
Var(X)=13/4.
Se elevó toda la diferencia al cuadrado; no se calculó x−μ².
Varianza cero permite una excepción nula
U uniforme en [0,1], X=1 si U=0 y X=0 en otro caso.
Ley
P(X=1)=0 y P(X=0)=1.Momentos
EX=E(X²)=0, así Var(X)=0.Resultado excepcional
En el resultado U=0, la función X sí vale 1.
X=0 casi seguramente, aunque no en todos los resultados del espacio.
La conclusión exacta de varianza cero usa probabilidad uno, no identidad punto por punto.
4. Trasladar cambia el centro; escalar cambia también la dispersión
La traslación b desaparece al centrar.
Las unidades ayudan: si X mide metros, su media y desviación también; la varianza mide metros cuadrados. Un factor negativo invierte el sentido del eje pero no produce una varianza negativa.
Un factor negativo no da dispersión negativa
EX=3, Var(X)=5, Y=−2X+7.
Centro
EY=−2·3+7=1.Varianza
Var(Y)=(−2)²·5=20.Desviación
σy=√20=2√5.
Media 1, varianza 20.
El signo menos cambia la orientación, no el tamaño cuadrático de las desviaciones.
Pasar de metros a centímetros
EX=1,5 m y Var(X)=0,04 m²; Y=100X en centímetros.
Media
EY=150 cm.Varianza
100²·0,04=400 cm².Raíz
σy=20 cm, igual a convertir 0,2 m.
Las conversiones de varianza usan el cuadrado del factor.
Multiplicar la varianza solo por 100 habría mezclado unidades.
5. La covarianza promedia el producto de dos desviaciones
El producto es integrable por Cauchy–Schwarz.
Desviaciones del mismo signo contribuyen positivamente; de signos opuestos, negativamente. Sumar constantes no cambia la covarianza, y Cov(aX+b, cY+d)=acCov(X, Y). Una covarianza cero descarta esa asociación lineal media, no toda dependencia.
Las desviaciones se refuerzan
X toma ±1 equiprobables y Y=2X.
Centros
EX=EY=0.Producto
XY=2X²=2 siempre.Covarianza
E(XY)−0=2.
Cov(X, Y)=2.
También Cov(X, X)=1 y multiplicar la segunda variable por 2 multiplica la covarianza por 2.
Una relación no lineal puede dar covarianza cero
X uniforme en [−1,1], Y=X².
Momentos
EX=0, EY=1/3 por integrar x²/2.Producto
E(XY)=E(X³)=0 por simetría e integrabilidad.Dependencia
Si |X|≤1/2, entonces Y≤1/4 con certeza; sin esa información su probabilidad es 1/2.
Cov(X, Y)=0, pero X e Y son dependientes.
Y está determinada por X; la covarianza no captura por sí sola la forma parabólica de esa relación.
6. La varianza de una suma conserva los términos cruzados
Expandimos [(X−EX)+(Y−EY)]² y promediamos: Var(X+Y)=Var(X)+Var(Y)+2Cov(X, Y). Para varias variables se añaden dos veces todas las covarianzas de parejas distintas.
Independencia y segundos momentos finitos implican covarianza cero, así las varianzas se suman. Basta incorrelación para esa identidad de suma, pero incorrelación no implica independencia. Las medias, en cambio, se sumaban sin esta condición.
La cancelación exacta necesita una covarianza negativa
Var(X)=5, Y=−X.
Varianza de Y
También vale 5.
Covarianza
Cov(X,−X)=−5.Suma
5+5+2·(−5)=0, coherente con X+Y=0.
Var(X+Y)=0.
Eliminar el término cruzado habría dado 10, contradiciendo una suma que es exactamente constante.
Una media de indicadores independientes
Ocho Bernoulli independientes de p=1/4; S es su suma.
Cada varianza
p(1−p)=3/16.Suma
Var(S)=8·3/16=3/2.Media
Para S/8, la varianza se divide por 64:3/128.
El promedio fluctúa menos que una observación individual.
El factor 1/8 se eleva al cuadrado al pasar de suma a media.
7. La correlación quita unidades pero sigue midiendo relación lineal
Si una desviación es cero, la correlación usual no está definida: no se asigna cero a una división por cero.
La igualdad |ρ|=1 significa que las variables centradas son proporcionales casi seguramente: hay una relación afín exacta entre variables no degeneradas. El signo depende de la pendiente.
Una pendiente negativa perfecta
Var(X)=4, Y=−3X+2.
Covarianza
Cov(X, Y)=−3·4=−12.Desviaciones
σx=2, Var(Y)=36 y σy=6.Normalizar
ρ=−12/(2·6)=−1.
Correlación −1, con relación afín decreciente exacta.
La constante 2 cambia la media, pero desaparece al centrar.
Cero correlación con una relación determinista
X toma −1,0,1 equiprobables, Y=X².
Medias
EX=0, EY=2/3.Covarianza
E(XY)=E(X³)=0, por lo que Cov=0.No degeneradas
Var(X)=2/3 y Var(Y)=2/9, así ρ=0 está definida, aunque Y se conoce al conocer X.
Correlación cero no demuestra independencia.
Por ejemplo, X=0 obliga Y=0, cuando sin condición P(Y=0)=1/3.
8. La varianza total separa diferencias internas y diferencias entre grupos
Para una partición de grupos con pesos positivos, EX=ΣP(Bi)E(X|Bi). Con segundo momento finito, Var(X)=E[Var(X|grupo)]+Var(E[X|grupo]). Cada media y varianza de grupo se pondera por su probabilidad.
La identidad sale de X−EX=(X−media del grupo)+(media del grupo−EX). Al cuadrar, el término cruzado tiene esperanza cero dentro de cada grupo. Lo restante es dispersión interna más separación de los centros.
Hacer las dos cuentas del dibujo
Grupo I pesa 3/4, toma 1 y 3 por igual; II pesa 1/4, toma 4 y 8 por igual.
Centros y varianzas
I: media 2, varianza 1. II: media 6, varianza 4.
Centro e interior
EX=(3/4)2+(1/4)6=3; varianza interna media=(3/4)1+(1/4)4=7/4.Entre centros
(3/4)(2−3)²+(1/4)(6−3)²=3.Total=7/4+3=19/4.
La varianza total es 19/4.
La ley completa tiene masas 3/8,3/8,1/8,1/8 en 1,3,4,8; la fórmula directa da el mismo resultado.
Grupos constantes pueden producir un conjunto disperso
Dos grupos de igual peso: en uno X=0 siempre, y en otro X=10 siempre.
Dentro
Ambas varianzas internas son cero.
Media total
EX=5.Entre grupos
(1/2)(0−5)²+(1/2)(10−5)²=25.
Var(X)=25, aunque dentro de cada grupo no haya variación.
Mirar solo las dispersiones internas habría ignorado la separación de sus medias.
9. Una matriz reúne todas las covarianzas y transforma las combinaciones
Para un vector con segundos momentos finitos, Σij=Cov(Xi, Xj). La matriz es simétrica y semidefinida positiva: para todo vector a, aᵀΣa=Var(ΣaiXi)≥0. La diagonal contiene varianzas; el resto, covarianzas.
Se obtiene expandiendo cada covarianza por bilinealidad. La traslación b desaparece. La matriz no determina por sí sola la ley conjunta; solo describe sus segundos momentos.
Construir una matriz desde variables simples
X, Z independientes, centradas, con varianzas 1 y 3; Y=2X+Z.
Entradas
Var(X)=1, Cov(X, Y)=2 y Var(Y)=4+3=7.Matriz
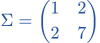 .
Una dirección
Var(Y−2X)=4−8+7=3, coherente con Y−2X=Z.
La matriz registra la relación lineal y el ruido añadido.
Su determinante es 7−4=3>0: ninguna combinación lineal no nula de este par tiene varianza cero.
Cambiar a diferencia y suma
Misma pareja; W=X−Y, V=X+Y.
Dos varianzas
Var(W)=1+7−4=4; Var(V)=1+7+4=12.Covarianza cruzada
Cov(X−Y, X+Y)=Var(X)−Var(Y)=−6.Resultado
La nueva matriz tiene filas (4,−6) y (−6,12), igual a AΣAᵀ para filas A=(1,−1),(1,1).
La nueva matriz es simétrica y tiene determinante 12.
Las covarianzas intermedias se cancelan al calcular el término cruzado, no se borran por independencia inventada.
10. Primero comprobamos qué momentos existen y después los interpretamos
Una varianza calculada negativa señala un error algebraico o numérico. Cuando los valores son grandes y su dispersión pequeña, restar E(X²)−(EX)² puede perder precisión; la definición centrada ayuda a comprobarlo. Unidades y casos constantes proporcionan otros controles.
Dos leyes pueden compartir media y varianza y tener colas muy distintas. Además, existencia de media no garantiza varianza finita. No se trasladan conclusiones que exigen segundo momento a variables para las que ese momento diverge.
Una media finita con dispersión cuadrática infinita
Densidad f(x)=(3/2)x^(−5/2) para x≥1, cero fuera.
Normalizar
Su integral es uno.
Media
EX=(3/2)∫₁∞x^(−3/2)dx=3.Momento segundo
E(X²)=(3/2)∫₁∞x^(−1/2)dx=+∞.
Tiene media 3 y varianza infinita.
La cola deja aplicar algunos resultados que solo requieren primer momento, pero no una fórmula con varianza finita.
Mismos momentos, no la misma ley
Compara X=±1 equiprobables con Z normal estándar.
Medias
Ambas son cero.
Varianzas
Ambas son uno.
Colas
P(|X|>2)=0, mientras P(|Z|>2)>0 porque la densidad normal es positiva allí.
La media y la varianza no reconstruyen toda la distribución.
Para probar independencia o calcular una cola específica hace falta información adicional a esos dos números.
Ahora lo resolvemos de principio a fin.
EJEMPLO RESUELTO 1
Bernoulli
Calcula media y varianza de Bernoulli(p).
Ley
Una Bernoulli vale 1 con probabilidad p y 0 con probabilidad 1−p.
Media
EX=1·p+0·(1−p)=p.Segundo momento
Como X²=X, E(X²)=p.Varianza
Var(X)=p−p²=p(1−p).Extremos
Si p=0 o p=1, la variable es constante y la varianza vale cero.Comprobación
Si p=1/2, la varianza es 1/4.Su desviación típica es la raíz, no la misma cantidad.
Media p; varianza p(1−p).
En p=0 o1 la varianza es cero; en p=1/2 es 1/4. Estos casos concuerdan con una variable constante o dos resultados igualmente probables.
EJEMPLO RESUELTO 2
Sumar sin independencia
Y=2X y Var X=3. Calcula Var(X+Y).
Relación
Y=2X, así X+Y=3X.Escala
Var(3X)=3²Var(X).Dato
Var(X)=3.Resultado
9·3=27.Por covarianzas
Var(Y)=12 y Cov(X, Y)=6, de modo que 3+12+2·6=27.Interpretación
Las fluctuaciones se refuerzan; no se suprime su covarianza porque Y está determinada por X.
27.
La desviación típica de X+Y es tres veces la de X; su varianza es nueve veces la original. La respuesta no necesita conocer EX.
Los símbolos que hemos usado
- E[X]
- Esperanza de X; finita cuando E|X|<∞.
- μ=E[X]
- Media de la variable integrable X.
- Var(X)
- Esperanza de (X−μ)², aquí manejada como finita cuando se usan identidades de segundos momentos.
- σ_X
- Desviación típica √Var(X), con las mismas unidades que X.
- Cov(X,Y)
- Esperanza del producto centrado (X−EX)(Y−EY), bien definida para X,Y con segundos momentos finitos.
- ρ_XY
- Correlación Cov(X,Y)/(σ_Xσ_Y), definida si ambas desviaciones son positivas.
Ahora te toca a ti.
Tienes cinco ejercicios. Inténtalos; las pistas te ayudan si te atascas.
Practicar este tema →