Una observación puede tener dos resultados posibles y, aun así, no aportar un bit nuevo cada vez. La entropía dinámica mide la información nueva por paso. Empezaremos por una observación, pasaremos a palabras de varios tiempos y solo después calcularemos una tasa.
Si necesitas repasar:
1. Primero medimos la sorpresa de un resultado y después su promedio
Con probabilidad p>0, la información del resultado es −log p. Un resultado poco probable sorprende más. Para una partición finita con probabilidades pᵢ, la entropía es 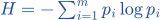 . i recorre los m resultados: calculamos cada término y luego los sumamos.
En base dos, la unidad es el bit; con logaritmo natural, el nat. Para convertir nats en bits dividimos entre log2 natural. Con m resultados, 0≤H≤log m: el máximo corresponde a probabilidades iguales y el mínimo a un resultado seguro. La cota superior se justifica por concavidad o por la desigualdad de entropía respecto a la distribución uniforme.
Leer un logaritmo de información
Un resultado tiene probabilidad 1/8.
Base
Medimos en bits: usamos log₂.
Potencia
2³=8, así que −log₂(1/8)=3.Significado
Ese resultado aporta tres bits de información al saberse que ocurrió.
La información de un resultado no es todavía el promedio de toda la observación.
Un resultado seguro p=1 aporta cero, porque log1=0.
Ponderar cada término antes de sumar
Cuatro resultados con probabilidades 1/2,1/4,1/8,1/8.
Información
Sus sorpresas son uno, dos, tres y tres bits.
Pesos
Las contribuciones medias son 1/2,1/2,3/8 y 3/8.
Suma
H=1/2+1/2+3/8+3/8=7/4 bits.
Es menor que dos bits, el máximo de cuatro resultados.
No sumamos las cuatro sorpresas sin sus probabilidades.
2. Registrar dos observaciones no siempre duplica la información
La parte condicional mide cuánto queda por saber de Y una vez conocido X. Sale de escribir p(x,y)=p(x)p(y|x) en parejas de probabilidad positiva y separar el logaritmo del producto.
La información condicional está entre cero y H(Y). Por eso H(X,Y)≤H(X)+H(Y), con igualdad bajo independencia. Si Y queda determinada por X, la parte condicional es cero aunque Y por separado parezca incierta. Las distribuciones marginales iguales no bastan para sumar sus entropías.
Dos bits equilibrados independientes
Cada posición puede ser cero o uno con probabilidades iguales.
Palabras
00,01,10 y 11 tienen probabilidad 1/4.
Información
Cada palabra aporta −log₂(1/4)=2 bits.Promedio
H=4·(1/4)·2=2 bits.
La independencia permite sumar un bit de cada posición.
Además H(Y|X)=1: saber el primer bit no determina el segundo.
Repetir el primer bit
Elegimos un bit equilibrado X y ponemos Y=X.
Posibles
Solo aparecen 00 y 11, cada una con probabilidad 1/2.
Entropía
H(X,Y)=1 bit.Condicional
Conocer X determina Y; H(Y|X)=0.
Cada marginal tiene un bit, pero el par conserva solo uno.
Si Y=1−X ocurre lo mismo: ser determinista dado X no exige repetir el mismo valor.
3. Una partición convierte la órbita en una palabra
Sea T medible y preservando una probabilidad μ. Una partición P etiqueta cada estado por la pieza donde está. Observar x,Tx,…,Tⁿ⁻¹x produce una palabra de longitud n. La pieza de estados que da una palabra es una intersección de Pᵢ₀, T⁻¹Pᵢ₁,…,T⁻⁽ⁿ⁻¹⁾Pᵢₙ₋₁.
El refinamiento Pⁿ reúne esas intersecciones. H(Pⁿ) es entropía conjunta del bloque, no la suma automática de entropías marginales. Aunque T sea determinista, el estado inicial puede estar distribuido según μ y la observación tener resolución limitada. La incertidumbre no exige lanzar un azar nuevo dentro de la fórmula de T.
Un nombre binario de dos pasos
D(x)=2x mod1 y P formada por las dos mitades del intervalo.
Nombre 01
Primero x está en [0,1/2); después D(x) está en [1/2,1).
Intersección
En esa primera rama, 1/2≤2x<1: x∈[1/4,1/2).Probabilidad
Con Lebesgue, esa palabra mide 1/4, igual que las otras tres palabras.
Dos tiempos revelan dos dígitos binarios en este ejemplo.
Los extremos se toman semiabiertos; cambiarlos en una parte nula no altera la entropía.
Una partición que no observa nada
P={X}, una sola pieza que contiene todo el espacio.
Palabra
Solo hay un nombre posible en cada longitud.
Probabilidad
Ese nombre tiene probabilidad uno.
Bloque
H(Pⁿ)=−1·log1=0 para todo n.
Una observación trivial siempre tiene tasa cero.
Eso no prueba que el sistema tenga entropía total cero.
4. La tasa es información por paso cuando el bloque se hace largo
Dividir un bloque de n+m en dos y usar invariancia de medida da aₙ₊ₘ≤aₙ+aₘ. Esta subaditividad y el lema de Fekete aseguran la existencia de h(T,P)=lim aₙ/n=inf aₙ/n.
Una tasa cero permite incertidumbre creciente si crece sublinealmente. La entropía de una posición no determina la tasa: hay que conservar las dependencias entre tiempos. La unidad aquí es bits o nats por iteración, según el logaritmo.
Un bloque que nunca añade información
Se elige un bit equilibrado y se repite para siempre.
Nombres
Para cada longitud n solo aparecen todos ceros o todos unos.
Bloque
H(Pⁿ)=1 bit, independientemente de n.Tasa
H(Pⁿ)/n=1/n→0.
Hay incertidumbre inicial pero no un bit nuevo en cada paso.
El dato marginal sigue teniendo un bit en cualquier tiempo.
Un bloque que sí añade un bit en cada posición
Bits equilibrados independientes.
Contar
Hay 2ⁿ palabras equiprobables.
Bloque
Cada una tiene probabilidad 2⁻ⁿ y H(Pⁿ)=n bits.Tasa
Dividir por n da uno para toda longitud.
La tasa es un bit por paso.
La comparación con repetición muestra por qué contar símbolos posibles no basta.
5. El supremo evita depender de una observación demasiado gruesa
La entropía métrica es hμ(T)=supP hμ(T,P), sobre particiones medibles finitas. Una partición generadora permite recuperar toda la información medible al observar sus iteraciones, módulo conjuntos nulos. En un sistema invertible se usan todos los tiempos enteros; en un sistema unilateral se pide la generación hacia delante cuando corresponda.
El teorema de Kolmogorov–Sinai afirma que un generador finito ya calcula hμ(T). Sin demostrar que la partición genera, su tasa proporciona una cota inferior. Tampoco se debe confundir entropía de la partición en un tiempo y tasa de la partición durante una órbita.
La observación trivial puede subestimar el sistema
Duplicación con Lebesgue.
Observar poco
La partición {X} tiene tasa cero.
Observar dígitos
Las dos mitades forman un generador unilateral mediante intervalos diádicos cada vez más pequeños.
Tasa completa
Su tasa es un bit y por Kolmogorov–Sinai es la del sistema.
El supremo recoge la información que perdía la partición trivial.
El papel generador se ha comprobado mediante los refinamientos, no solo nombrándolo.
Dos dígitos iniciales no dan dos bits nuevos por paso
Usar los cuatro cuartos como partición de la duplicación.
Primer tiempo
Se ven dos dígitos: H(P)=2 bits.Bloque
En n tiempos se ven n+1 dígitos distintos, porque las observaciones se solapan.
Tasa
H(Pⁿ)/n=(n+1)/n→1 bit por paso.
Una partición más fina puede aumentar información inicial sin cambiar la tasa.
Los cuatro cuartos refinan al generador de dos mitades y también generan.
6. Bernoulli y Markov permiten calcular tasas con sus dependencias precisas
En un desplazamiento de Bernoulli, las coordenadas son independientes con probabilidades pᵢ.
La tasa es H(p). No se exige que todas las probabilidades sean iguales.
En una cadena de Markov finita estacionaria, πP=π y el siguiente símbolo depende del presente por la fila Pᵢ·.
La tasa es el promedio de entropías de filas, −ΣπᵢPᵢⱼlogPᵢⱼ.
Dos filas con la misma incertidumbre
P tiene filas (3/4,1/4) y (1/4,3/4), con π=(1/2,1/2).
Estacionaria
Multiplicar π por P devuelve (1/2,1/2).
Cada fila
Su entropía es −(3/4)log₂(3/4)−(1/4)log₂(1/4), aproximadamente 0,8113 bits.
Promediar
Como ambas filas tienen la misma entropía, esa es la tasa.
El bloque tiene 1+(n−1)·0,8113 bits aproximadamente.
La entropía marginal de un bit es uno; la dependencia reduce lo nuevo por transición.
Una cadena estacionaria que alterna sin incertidumbre nueva
P tiene filas (0,1) y (1,0), con π=(1/2,1/2).
Primer símbolo
Tiene un bit de incertidumbre.
Transiciones
Cada fila obliga al otro símbolo y tiene entropía cero.
Tasa
El bloque conserva un bit inicial; la tasa es cero.
Un proceso estacionario puede tener marginal incierta y transiciones deterministas.
La irreducibilidad de este ciclo no lo convierte en una fuente de bits independientes.
7. El mismo mapa tiene entropías distintas con medidas distintas
Con Lebesgue, el generador binario de D(x)=2x mod1 da 2ⁿ intervalos de longitud 2⁻ⁿ en un bloque de n pasos. La entropía es nlog2 nats y la tasa log2 nats por iteración, equivalente a un bit.
Con δ₀, la masa puntual en su punto fijo, toda partición tiene un único nombre con probabilidad uno. Su entropía métrica es cero. La fórmula algebraica del mapa es la misma: lo que cambia es la distribución de estados. Los puntos periódicos de una medida nula no determinan la entropía de Lebesgue.
Cambiar de nats a bits
La tasa de duplicación con Lebesgue es log2 natural.
Conversión
Para pasar a bits dividimos por log2 natural.
Cociente
(log2)/(log2)=1.Unidad
El resultado es un bit por iteración.
Las dos cifras representan la misma tasa con unidades distintas.
log2 natural es aproximadamente 0,6931 nats; no se redondea a un bit sin convertir.
Una medida sobre un punto fijo
La órbita observada es 0,0,0,… y μ=δ₀.
Nombre
Cada partición asigna una etiqueta concreta a cero.
Probabilidad
Ese único nombre repetido tiene probabilidad uno.
Entropía
Todos los bloques y todas sus tasas son cero; el supremo también es cero.
hδ₀(D)=0 aunque hLebesgue(D)=log2.
La derivada local de D puede tener tasa log2; no se igualan automáticamente entropía y exponente tangente.
8. La entropía topológica cuenta órbitas distinguibles sin asignar probabilidades
Para T continua sobre un compacto métrico, dₙ(x,y)=max₀≤j<n d(Tʲx,Tʲy). Un conjunto es (n,ε)-separado si cada pareja se distingue por más de ε en algún instante del bloque. El crecimiento exponencial del máximo número sₙ(ε), primero en n y luego al reducir ε, define htop(T).
El principio variacional afirma htop(T)=supμ hμ(T) entre probabilidades borelianas invariantes. No dice que todas las medidas alcancen ese supremo ni garantiza siempre una maximizante. Una rotación isométrica conserva dₙ=d, así que sus cantidades separadas no crecen con n y su entropía topológica es cero.
Una rotación no aumenta la separación de un bloque
Rα es una isometría del círculo.
Cada tiempo
d(Rαʲx,Rαʲy)=d(x,y).Máximo
dₙ(x,y)=d(x,y).Contar
Para ε fijo, el máximo número separado no depende de n: log sₙ/n→0.
La entropía topológica es cero incluso si la rotación es irracional y ergódica.
Ergodicidad y entropía positiva responden a preguntas diferentes.
Una medida no tiene por qué alcanzar la complejidad del mapa
La duplicación del círculo tiene entropía topológica log2.
Conteo
Las 2ⁿ posiciones diádicas se distinguen en n pasos a resolución menor que un medio; la expansión de factor dos da también una cota superior del mismo orden exponencial.
Una medida
Lebesgue tiene entropía log2 y alcanza ese valor.
Otra medida
δ₀ tiene entropía cero y no lo alcanza.
El principio variacional toma un supremo, no una igualdad para cada medida.
El conteo topológico se realiza en el círculo compacto, con su métrica.
9. La base, la medida y el tiempo forman parte de la cifra de entropía
Una conjugación medible invertible módulo nulos que preserve medidas y entrelace los mapas transporta particiones con sus probabilidades; conserva la entropía métrica. Cambiar el paso temporal sí cambia la unidad: hμ(Tᵏ)=k hμ(T), para k entero positivo.
La entropía no clasifica todos los sistemas. Mezcla, ergodicidad y exponentes de Lyapunov añaden información distinta. Las fórmulas que relacionan entropía y exponentes requieren regularidad y condiciones sobre la medida. Una muestra finita puede omitir palabras raras y sesgar una estimación: no prueba sola el límite asintótico.
Cambiar el tamaño de un paso
Duplicación con un bit por iteración; observar ahora T³.
Nuevo paso
Se han aplicado tres iteraciones originales.
Tasa
h(T³)=3h(T)=3 bits por nuevo paso.Comparar
Dividir entre la duración tres recupera un bit por paso original.
Las unidades temporales evitan una falsa diferencia entre tasas.
La medida invariante y la base de logaritmo se mantienen iguales.
Contar solo lo observado puede ocultar información
Una muestra de dos símbolos solo ha mostrado ceros.
Posibilidades
Puede venir de un proceso seguro o de una muestra corta de uno que también produce unos raros.
Dato faltante
La ausencia observada no demuestra probabilidad exactamente cero.
Conclusión
Se necesita un modelo, más información o control estadístico antes de afirmar entropía nula.
Una cuenta de frecuencias finita no sustituye la definición dinámica.
La teoría de esta lección calcula límites para sistemas y medidas declarados.
Ahora lo resolvemos de principio a fin.
EJEMPLO RESUELTO 1
Un bit equilibrado
Calcula la entropía de dos símbolos de probabilidad 1/2 en bits.
Datos
Dos resultados tienen probabilidades 1/2 y 1/2; medimos en bits.
Fórmula
H=−Σpᵢlog₂pᵢ.Logaritmo
log₂(1/2)=−1.Contribuciones
Cada término aporta −(1/2)(−1)=1/2 bit.Sumar
H=1/2+1/2=1 bit.Comprobar
Es log₂2, el máximo posible para dos resultados.
La entropía es 1 bit.
Es el máximo para dos símbolos.
EJEMPLO RESUELTO 2
Tres pasos independientes
Tres bits equilibrados independientes: calcula la entropía conjunta.
Datos
Tres bits equilibrados e independientes.
Palabras
Hay 2³=8 palabras de longitud tres.Probabilidad
La independencia da (1/2)³=1/8 para cada palabra.Información
−log₂(1/8)=3 bits por palabra.Promediar
H=8·(1/8)·3=3 bits.Comprobar
Equivale a sumar las tres entropías de un bit porque son independientes. Repetir un mismo bit tres veces daría solo uno.
La entropía conjunta es 3 bits.
Hay 8 palabras equiprobables.
Los símbolos que hemos usado
- ℘={P₁,…,Pₘ}
- Partición medible finita del espacio de probabilidad, con átomos disjuntos salvo conjuntos nulos.
- pᵢ=μ(Pᵢ)
- Probabilidad de observar el símbolo i al registrar en qué átomo cae el estado.
- Hμ(℘)
- Entropía estática −Σᵢpᵢlog pᵢ, con la convención0log0=0.
- ℘∨𝒬
- Refinamiento conjunto formado por intersecciones Pᵢ∩Qⱼ; registra dos observaciones.
- ℘ⁿ=∨ⱼ₌₀ⁿ⁻¹T⁻ʲ℘
- Partición de las palabras observadas durante n pasos, empezando en el tiempo0.
- hμ(T,℘), hμ(T)
- Tasa de entropía para la observación ℘ y supremo de esas tasas sobre particiones finitas.
- H(Y|X)
- Entropía condicional de Y tras conocer X, promedio de las entropías de las distribuciones condicionales.
- h_top(T)
- Entropía topológica: crecimiento de órbitas distinguibles a resolución espacial fija y luego cada vez más fina.
- πᵢ, Pᵢⱼ
- Probabilidades estacionarias y matriz de transición de una cadena de Markov finita.
Ahora te toca a ti.
Tienes cinco ejercicios. Inténtalos; las pistas te ayudan si te atascas.
Practicar este tema →