Queremos enviar un mensaje, pero el receptor puede ver un símbolo distinto del enviado. Dibujaremos primero esas posibilidades. Después distinguiremos tres preguntas: cuánto sabemos de un mensaje, qué hace un código concreto y qué tasas permiten transmitir con errores cada vez menores.
Si necesitas repasar:
1. Una fila del canal describe qué puede llegar al enviar un símbolo
La entrada X es lo que enviamos y la salida Y lo que se recibe. W(y|x) es la probabilidad de recibir y cuando se envía x. Cada fila fija una entrada y reparte probabilidad uno entre todas las salidas. Primero se especifica el canal; después elegimos con qué frecuencia enviar cada entrada.
Usaremos alfabetos finitos y un canal sin memoria: dadas las entradas, los usos tienen transiciones independientes, 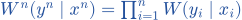 . No se supone que cualquier secuencia de entradas sea independiente: un código puede relacionar sus posiciones.
Leer una fila
Cada bit cambia con probabilidad 1/10.
Entrada cero
Llega cero con 9/10 y uno con 1/10.
Entrada uno
Llega cero con 1/10 y uno con 9/10.
Comprobar
Cada fila suma uno; las cuatro casillas juntas suman dos.
Las filas son distribuciones condicionadas distintas.
No dividimos por dos las filas para que toda la matriz sume uno.
Dos usos
Se envía 01 con ruido independiente de probabilidad 1/10.
Recibir 01
Ningún cambio: (9/10)²=81/100.Recibir 11
Cambia solo la primera posición: (1/10)(9/10)=9/100.Completar
00 tiene 9/100 y 10 tiene 1/100; total uno.
El producto calcula una salida concreta, no la probabilidad de todas a la vez.
Si el ruido tuviera memoria, este producto necesitaría otra justificación.
2. La entropía mide incertidumbre, no cuenta errores
Si un resultado tiene probabilidad p, su sorpresa en bits es −log₂p. La entropía promedia esa sorpresa:  , con 0·log₂0=0 por continuidad. Un resultado seguro no sorprende; dos equiprobables aportan un bit.
H(Y|X) promedia la entropía de cada fila del canal con los pesos de las entradas. La información mutua 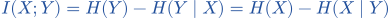 mide incertidumbre eliminada al conocer la otra variable. No es una probabilidad de acertar.
Tres distribuciones
Compara un bit seguro, uno equilibrado y uno con probabilidad 1/4 de ser uno.
Seguro
H=−1·log₂1=0.Equilibrado
Dos términos de 1/2 bit suman uno.
Sesgado
H₂(1/4)=−(1/4)log₂(1/4)−(3/4)log₂(3/4)≈0,811 bits.
Tener dos valores posibles no obliga a tener un bit de entropía.
Las probabilidades también importan.
Saber o no saber la entrada
X es uniforme. Compara Y=X con Y independiente y uniforme.
Copia
H(Y)=1 y H(Y|X)=0: I=1.Independencia
H(Y)=1 y H(Y|X)=1: I=0.Diferencia
En ambos casos vemos ceros y unos equilibrados; solo en el primero informan de X.
La distribución de salida sola no mide la calidad del canal.
Hay que estudiar la relación entre entrada y salida.
3. La capacidad elige la mejor distribución de entradas
Para este canal discreto finito sin memoria y sin restricciones adicionales, 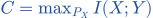 . W permanece fija: variamos la distribución de entrada. La maximización encuentra la mayor información mutua por uso, no modifica las probabilidades físicas del ruido.
La unidad es bits por uso. Una velocidad en bits por segundo requiere además especificar usos por segundo. Restricciones de coste, memoria o alfabetos distintos cambian el problema; la fórmula se interpreta dentro de las hipótesis declaradas.
Una mala elección desperdicia un canal perfecto
El canal copia sin errores. Compara enviar siempre cero con enviar ceros y unos equiprobables.
Siempre cero
El receptor ya conocía el símbolo: H(X)=I=0.Equilibrado
H(X)=I=1 bit por uso.Optimizar
Ninguna entrada binaria tiene entropía mayor que uno; C=1.
Capacidad uno no significa que toda estrategia transmita un bit.
La información de la fuente y la del canal deben distinguirse.
Cambiar de unidad
Un sistema ideal admite 2000 usos por segundo y C=3/4 bits por uso.
Multiplicar
2000·3/4=1500 bits por segundo.Interpretar
Es la tasa límite del modelo, con bloques adecuados.
Cautela
No garantiza que un código corto concreto logre ese rendimiento.
La capacidad sola no contenía un reloj.
No confundimos bits por uso con una probabilidad del 75 %.
4. En el canal binario simétrico se suma un bit de ruido
XOR da cero si los bits coinciden y uno si difieren.
Entre usos el ruido es independiente.
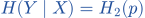 .
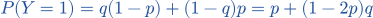 .
Un uno puede venir de un uno conservado o de un cero cambiado; son caminos incompatibles y se suman.
Una fuente sesgada
q=1/5 y p=1/10.
Uno conservado
(1/5)(9/10)=18/100.Cero cambiado
(4/5)(1/10)=8/100.Sumar
P(Y=1)=26/100.I=H₂(0,26)−H₂(0,1)≈0,358 bits.
La salida no queda uniforme porque la fuente tampoco lo era.
La información es menor que la que obtendremos optimizando.
Un ruido equilibrado borra la relación
p=1/2 y q cualquiera.
Salida uno
1/2+(1−1)q=1/2.Cada fila
Con entrada cero o uno, ambas salidas tienen probabilidad 1/2.
Conclusión
La distribución de salida no depende de lo enviado: I=0.
El canal no transporta información sobre el mensaje.
Cambiar la frecuencia de entrada no arregla filas idénticas.
5. La capacidad del BSC se obtiene con una cota y una entrada que la alcanza
 .
Para demostrar capacidad no basta esta cota: hay que conseguir la igualdad.
Elegimos X uniforme. La fórmula anterior da P(Y=1)=1/2 para todo p; por tanto H(Y)=1.
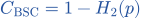 .
Ruido de un décimo
p=0,1.
Entropía
H₂(0,1)≈0,468996.Restar
C≈1−0,468996=0,531004 bits por uso.Comparar
No es 0,9: conservar el 90 % de símbolos no equivale a capacidad 0,9.
La capacidad incorpora incertidumbre sobre dónde ocurrieron los cambios.
El valor 0,358 del ejemplo sesgado es inferior a esta capacidad.
Cambiar siempre es reversible
Compara p=0, p=1/2 y p=1.
Cero
Y=X; capacidad uno.Un medio
Y es independiente de X; capacidad cero.
Uno
Y=1−X siempre.El receptor invierte el bit; capacidad uno.
Lo imprevisible perjudica; un cambio conocido puede deshacerse.
La capacidad no decrece en todo el intervalo de cero a uno.
6. La tasa de un código dice cuánto mensaje cabe en un bloque
Un codificador asigna M mensajes a palabras de longitud n. Un decodificador estima el mensaje a partir de lo recibido. Con mensajes uniformes, la tasa es 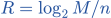 bits por uso.
La probabilidad de error depende también del código, del ruido y del decodificador.
La mayoría corrige un cambio; dos o tres cambios la llevan al mensaje contrario. Aquí se calcula error promedio de mensaje bajo ruido independiente.
Calcular el error de repetición
BSC con p=1/10 y decodificación por mayoría.
Dos cambios
Hay tres posiciones posibles para el bit que no cambia: 3p²(1−p).
Tres cambios
Probabilidad p³.
Total
3p²−2p³=28/1000=0,028, frente a 0,1 sin repetir.
Se reduce el error, a cambio de usar tres veces el canal por bit.
El error sigue siendo positivo.
Una tasa por debajo de capacidad no basta
Para p=1/10, C≈0,531 y la repetición triple tiene R=1/3.
Comparar
1/3<0,531.Observar
Su error calculado es 0,028.
Distinguir
R<C permite buscar familias de buenos códigos; no vuelve perfecto este bloque de longitud tres.
La desigualdad de tasas no sustituye analizar el código.
Tampoco afirma que repetir sea la construcción más eficiente.
7. El teorema de Shannon habla de una familia de bloques crecientes
Para un canal discreto finito sin memoria, cualquier tasa fija R<C puede aproximarse mediante códigos de longitudes crecientes cuyo error promedio de mensaje tiende a cero. Se elige una familia de códigos adecuada. Es una afirmación de existencia y límite, no una promesa sobre cualquier bloque.
Una tasa fija R>C no permite que el error tienda a cero en este marco. El teorema no da por sí solo un algoritmo rápido ni garantiza error exactamente cero. En C=0 no existe una tasa positiva por debajo de capacidad.
Leer correctamente “tiende a cero”
Imagina una familia con errores 0,1; 0,01; 0,001 al aumentar la longitud.
Cada bloque
Todavía puede fallar.
Límite
La probabilidad puede hacerse tan pequeña como se pida usando un bloque apropiado.
No deducir
No hay un último bloque mágico con error necesariamente cero.
Error arbitrariamente pequeño y error nulo son afirmaciones distintas.
La lista ilustra un límite; no se afirma que sea la curva de un código específico.
Elegir una tasa objetivo
Un canal tiene capacidad 1/2.
R=2/5
Está por debajo: hay familias con error que tiende a cero.
R=3/4
Está por encima: ese objetivo es imposible en el modelo.
Coste
Bloques, cálculo y retraso deben estudiarse aparte.
La capacidad orienta qué objetivos son alcanzables.
El enunciado no resuelve automáticamente el caso frontera R=C.
8. Fano transforma información limitada en una cota de error
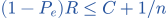
Sea U un mensaje uniforme entre M≥2, codificado sin realimentación en n entradas del canal. Si el error de su estimación es  , Fano da
 . La incertidumbre que queda se acota mediante los posibles errores.
Por procesamiento de datos y el canal sin memoria, 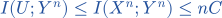 .
 .
Es una cota necesaria; no construye códigos.
Una tasa demasiado alta obliga a fallar
C=1/2, n=100 y R=3/4, es decir M=2⁷⁵.
Sustituir
(1−)·0,75≤0,5+0,01=0,51.Dividir
1−≤0,68.Despejar
≥0,32.
Ningún código de estos parámetros puede tener error promedio menor que 0,32.
La cota puede ser poco ajustada; no dice que 0,32 se alcance.
Pasar al límite
Mantén R fija y deja que n crezca con →0.
Izquierda
(1−)R→R.Derecha
C+1/n→C.Conclusión
Necesariamente R≤C.
Así se justifica la imposibilidad por encima de capacidad.
Para R<C esta desigualdad sola no prueba existencia.
9. Un borrado conocido no es lo mismo que un cambio oculto
En el canal binario de borrados, con probabilidad ε se recibe “?” y con probabilidad 1−ε se recibe el bit correcto. El receptor sabe qué posiciones faltan. El borrado es independiente del valor enviado.
Al recibir un bit conocemos X; al recibir “?” queda toda la incertidumbre original.
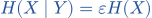 e
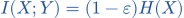 .
Un cuarto de borrados
ε=1/4 y entrada uniforme.
Sin borrado
Probabilidad 3/4; aprendemos el bit.
Con borrado
Probabilidad 1/4; no aprendemos su valor.
Media
I=3/4 bits por uso y esta entrada alcanza capacidad.
La marca “?” aporta localización de la pérdida.
No es el mismo canal que cambiar un bit con probabilidad 1/4.
Una salida concreta
Se envía 1010 y se recibe 1?10.
Leer
Las posiciones uno, tres y cuatro son conocidas.
Pendiente
El segundo bit podría ser cero o uno si no usamos redundancia.
Código
Una restricción entre posiciones podría permitir reconstruirlo.
Saber dónde falta un símbolo ayuda, pero no inventa el símbolo.
La capacidad es asintótica; no asegura recuperar cada patrón de borrados.
Ahora lo resolvemos de principio a fin.
EJEMPLO RESUELTO 1
Canal completamente ruidoso
Calcula C para p=1/2.
Modelo
Es un BSC con p=1/2.Entropía
H₂(1/2)=−(1/2)(−1)−(1/2)(−1)=1.Fórmula
C=1−H₂(p).Restar
C=1−1=0 bits por uso.Interpretar
Las dos filas del canal son idénticas.
Comprobar
Con entrada equiprobable la salida es independiente; de hecho ocurre con cualquier entrada.
La capacidad es 0.
La salida es independiente de la entrada equiprobable.
EJEMPLO RESUELTO 2
Tasa de código
Un código transmite 4 bits de información en bloques de 7. Calcula su tasa.
Mensaje
Hay cuatro bits de información: 2⁴=16 mensajes posibles.
Bloque
Cada palabra ocupa siete usos del canal.
Tasa
R=log₂16/7.Calcular
log₂16=4; R=4/7.Unidad
Bits de mensaje por uso, aproximadamente 0,5714.
Comprobar
No hemos calculado probabilidad de error ni capacidad del canal.
R=4/7.
No se confunde la tasa con la probabilidad de error.
Los símbolos que hemos usado
- W(y|x)
- Probabilidad de salida y cuando entra x.
- Sin memoria
- Los usos siguen la misma ley y son condicionalmente independientes dadas las entradas.
- H(X)
- Entropía, medida en bits cuando el logaritmo es de base dos.
- I(X;Y)
- Información mutua entre entrada y salida.
- C
- Capacidad en bits por uso del canal definido.
- R=k/n
- Tasa de k bits de información por n usos en el modelo binario.
- P_e
- Probabilidad de error de decodificación bajo el criterio especificado.
Ahora te toca a ti.
Tienes cinco ejercicios. Inténtalos; las pistas te ayudan si te atascas.
Practicar este tema →