Podemos querer un solo número, como una media, sin conocer toda la distribución. La inferencia semiparamétrica estudia ese objetivo pequeño dentro de un modelo con componentes muy flexibles. Empezaremos con contribuciones a una media y después veremos cómo corregir datos que faltan.
Si necesitas repasar:
1. El parámetro de interés puede ser finito aunque el modelo no lo sea
Un modelo estadístico especifica qué distribuciones P admitimos para los datos. El objetivo θ(P) puede ser una media real, mientras que P conserva infinitas posibilidades. A veces se llama no paramétrico al modelo y semiparamétrica a la tarea de inferir su parámetro finito: lo importante es declarar sus restricciones.
No elegir una familia normal no elimina hipótesis. Siguen importando el muestreo, los momentos y la identificación: distribuciones observadas iguales deben determinar el mismo objetivo. Una función auxiliar es parte del modelo que necesitamos estimar aunque no sea el número final que queremos informar.
Una media sin imponer una familia de densidades
X tiene segundo momento finito; θ(P)=E X.
Objetivo
θ es un solo número.
Modelo
P puede ser discreta, continua o una mezcla; no se ha fijado una familia con pocos parámetros.
Estimador
La media muestral sigue disponible con observaciones iid.
Un objetivo finito no exige un modelo paramétrico completo.
El segundo momento sí se ha impuesto para estudiar su incertidumbre normal.
Una función desconocida que no es el objetivo final
Y es una respuesta y X unas características.
Auxiliar
m(x)=E(Y|X=x) es una función de x.Objetivo
Podemos querer solo θ=E Y=E m(X).Distinción
Estimar m puede ayudar a θ sin que necesitemos informar toda la curva m como resultado final.
Nuisance significa componente auxiliar, no componente irrelevante.
Su error puede influir en la inferencia de θ.
2. La expansión lineal identifica qué promedio domina el error
Una representación asintóticamente lineal es 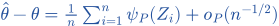 . La función ψ asigna una contribución a cada observación. Se exige Eψ=0 y Eψ²<∞; para un límite normal no degenerado, Varψ>0.
El resto debe desaparecer a esa escala. Esta expansión no garantiza por sí sola convergencia de varianzas reales ni regularidad frente a todas las perturbaciones del modelo. Esas son condiciones adicionales cuando se estudia eficiencia.
Leer el tamaño de un resto
La expansión tiene resto Rₙ=n⁻³ᐟ⁴.
Escalar
√nRₙ=n⁻¹ᐟ⁴.Comparar
Tiende a cero, así que el resto no cambia el límite del promedio.
Varianza límite
Si Eψ²=9, el límite escalado tiene varianza nueve.
El promedio de influencias domina a primer orden.
El resto n⁻¹ᐟ⁴ no sería admisible con la misma justificación.
La función y su evaluación son objetos distintos
ψ(x)=x−4 y se observa x=7.
Función
ψ es la regla restar cuatro.
Evaluación
ψ(7)=3.Aleatoriedad
Antes de observar, ψ(X) es aleatoria porque X lo es.
Tres es una contribución con signo, no una probabilidad.
Para x=2, la contribución sería −2.
3. La media tiene una influencia que se ve en una identidad exacta
La función está centrada y su varianza es Var X, si el segundo momento existe.
En el modelo no paramétrico usual de distribuciones con momentos adecuados, esta función representa la sensibilidad de la media y es su gradiente canónico. En un modelo restringido hay que revisar el espacio tangente. Una influencia eficiente no se decide por mirar solo un promedio de una muestra.
Reconstruir el error sumando contribuciones
Datos uno, tres y cinco; valor de referencia μ=4.
Contribuciones
Son −3,−1 y 1.
Promedio
(−3−1+1)/3=−1.Comprobar
La media de los datos es tres y X̄−μ=3−4=−1.
La expansión de la media es una identidad, no una aproximación.
El μ usado como referencia se ha fijado explícitamente.
Pasar de la influencia a la incertidumbre
Var X=16 y n=64.
Influencia
ψ=X−μ tiene varianza dieciséis.Media
Var X̄=16/64=1/4 exactamente en el muestreo iid.Error estándar
Es 1/2.
La varianza de la influencia pertenece a la escala √n.
No es la varianza sin escalar de la media.
4. Una función centrada debe además representar la sensibilidad correcta
Consideramos submodelos regulares Pε que pasan por P. Su score s describe el cambio relativo de densidad y tiene media cero. Una influencia de un estimador regular debe cumplir 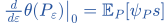 para todas las direcciones permitidas.
Para la media, diferenciar su integral bajo condiciones apropiadas da E[Xs].
Centrar una función cualquiera no garantiza esa identidad. El siguiente modelo finito hace visible la cuenta; en un modelo general se revisa cada dirección regular.
Perturbar una distribución de tres puntos
Valores 1,3,5 y probabilidades (1/3−ε,1/3,1/3+ε), |ε|<1/3.
Media
μ(ε)=1(1/3−ε)+3/3+5(1/3+ε)=3+4ε.Score
En cero vale s=(−3,0,3); la influencia de la media es ψ=(−2,0,2).Comprobar
Eψs=(6+0+6)/3=4, igual a μ′(0).
La identidad conecta cambios de probabilidades con contribuciones de observaciones.
La condición |ε|<1/3 mantiene probabilidades positivas.
Centrada, pero con sensibilidad equivocada
En el mismo modelo, proponer η=2ψ.
Media
Eη=2Eψ=0.Sensibilidad
Eηs=2Eψs=8.Fallo
La derivada real de la media es cuatro, no ocho.
η no es la influencia correcta del mismo parámetro en esta dirección.
El fallo no se detecta comprobando solo que su media sea cero.
5. La proyección elimina variación que no representa cambios del parámetro
En L²₀(P), el producto interior es ⟨f,g⟩=E(fg); trabajamos con funciones centradas de segundo momento finito. El espacio tangente T es el cierre de la envolvente lineal de los scores de submodelos regulares. Es cerrado por definición, de modo que existe proyección ortogonal.
Proyectar una influencia válida en T da el gradiente canónico. Una componente en T⊥ no cambia los productos con los scores, pero añade norma al cuadrado. Pitágoras explica la varianza mínima entre representantes; la cota para estimadores regulares y la construcción de uno que la alcance requieren el marco de regularidad correspondiente.
Misma sensibilidad con una componente extra
Modelo de tres puntos anterior; ψ=(−2,0,2), ζ=(1,−2,1).
Ortogonalidad
Eζ=0 y Eψζ=(−2+0+2)/3=0.Misma dirección
El score genera T=span ψ.Para φ=ψ+ζ, Eφs=Eψs=4.Varianzas
Varψ=8/3, Varζ=2 y Varφ=14/3.
La componente extra no mejora la sensibilidad y sí aumenta la varianza.
Este ejemplo describe el submodelo de una dirección indicado, no todos los scores de un modelo irrestricto.
Proyectar en un modelo irrestricto
En una distribución de tres puntos con probabilidades positivas, se permiten todas las perturbaciones centradas.
Espacio
Los scores generan todo L²₀(P), de dimensión dos.
Exigir todas las direcciones
Una componente no nula ya no puede esconderse en T⊥ dentro de L²₀.
Consecuencia
Para la media, ψ=x−μ es el representante canónico único.
Restringir o ampliar el modelo cambia qué componentes son admisibles.
La φ extra del ejemplo anterior no representa necesariamente las direcciones nuevas.
6. Las funciones auxiliares aparecen de forma concreta cuando faltan respuestas
Con momentos suficientes, la influencia eficiente del modelo MAR es 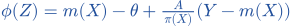 .
En los ejemplos usamos auxiliares conocidas para ver la cuenta; al estimarlas habrá que controlar su error.
Una observación corrige una predicción auxiliar
m(x)=2, π(x)=1/4, A=1 y Y=3; θ=4.
Residuo
Y−m=1.Ponderar
A/π=4, así F=2+4·1=6.Centrar
φ=F−θ=6−4=2.
La influencia combina predicción y residuo observado ponderado.
Con A=0 se usa F=m(x); no se exige conocer el Y ausente.
Una corrección puede reducir variación respecto a ponderar solo
X=0 o 1 equiprobable; Y=m(X), con m(0)=2,m(1)=6 y π(0)=1/4,π(1)=3/4.
Media
θ=(2+6)/2=4; suponemos MAR.Solo ponderar
AY/π vale ocho cuando A=1 y cero en otro caso; P(A=1)=1/2. Su varianza es dieciséis.
Con m correcta
El residuo es cero y F=m(X), que vale dos o seis: su varianza es cuatro.
La regresión aporta información útil cuando está justificada y bien estimada.
Son cálculos con auxiliares conocidas; no garantizan ese rendimiento en cada muestra entrenada.
7. Cross-fitting separa entrenamiento y evaluación sin borrar las hipótesis
Con K particiones de tamaño comparable y K fijo, entrenamos los auxiliares fuera de cada partición y evaluamos F en los datos que quedaron fuera del entrenamiento. Después promediamos las contribuciones. Esto facilita controlar el error de evaluación bajo independencia del ajuste y de su muestra de prueba.
Las contribuciones de todas las particiones no son literalmente iid, pues los entrenamientos se solapan. El teorema maneja esa dependencia. Se siguen necesitando consistencia de auxiliares, tasas, momentos y denominadores protegidos. Cross-fitting no identifica información que el diseño no observa.
Dos mitades con papeles que se intercambian
Una muestra se divide en I₁ e I₂.
Primera evaluación
Entrenar m y π con I₂ y calcular F para observaciones de I₁.
Segunda evaluación
Entrenar con I₁ y evaluar I₂.
Reunir
Promediar todas las contribuciones con los ajustes de fuera de su propia mitad.
Cada observación se evalúa con una función que no se entrenó usando ella.
No se afirma independencia exacta entre las dos medias finales.
Una región sin respuestas observadas
X=0 y X=1 tienen probabilidad 1/2; nunca se observa Y cuando X=1.
Fallo de positividad
π(1)=0.Ambigüedad
Los datos no distinguen si la media de Y en esa región es cero o cien.
Objetivo
La media total podría diferir en cincuenta sin cambiar la ley observada.
Ninguna separación de muestra resuelve esa falta de identificación sin supuestos extra.
No se divide por una propensión cero.
8. La varianza eficiente es de primer orden y debe estimarse a la escala correcta
La aproximación de varianza sin escalar es V/n y el error estándar √(V/n). La convergencia de varianzas reales requiere controles adicionales de momentos.
Con contribuciones estimadas por cross-fitting y condiciones de consistencia y momentos apropiadas, su varianza empírica estima V. Si V>0 y el límite normal es válido, se construyen intervalos con esa escala. Alcanzar la cota eficiente es una propiedad relativa al modelo y a estimadores regulares, no un premio automático para cualquier algoritmo predictivo.
No confundir varianza límite y error estándar
V=25 y n=100.
Varianza aproximada
V/n=25/100=1/4.Error estándar
√(1/4)=1/2.Escala raíz de n
La desviación del límite escalado es cinco.
Son tres cifras distintas: 25, 1/4 y 1/2.
Para el margen de un intervalo se usa 1/2.
La cota depende del modelo
En el ejemplo finito, una dirección da T=span ψ y el modelo irrestricto da T=L²₀.
Direcciones
Una restricción reduce las perturbaciones que debemos representar.
Proyección
La proyección se calcula en el T del modelo realmente asumido.
Informe
Una comparación de eficiencia debe declarar ese modelo y la clase regular de estimadores.
Una varianza pequeña fuera de una hipótesis correcta no garantiza inferencia válida.
La identificación y la expansión se comprueban antes de comparar cotas.
9. La ortogonalidad deja un producto de errores y explica la doble robustez
Para el ejemplo MAR, usemos ajustes m̃,π̃ con π̃ protegida por una cota positiva. Condicionando en un ajuste entrenado fuera de la evaluación, el sesgo poblacional de F̃ es 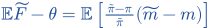 . Desaparece si cualquiera de los dos auxiliares es exactamente correcto. Esa es la doble robustez de la identidad, que por sí sola no prueba normalidad.
Cauchy–Schwarz acota el resto por una constante por ||π̃−π||₂||m̃−m||₂. Para hacerlo oₚ(n⁻¹ᐟ²) necesitamos un producto menor que esa escala. Con cross-fitting de K fijo, auxiliares L²-consistentes, propensiones acotadas inferiormente, varianza condicional del residuo acotada y ese producto despreciable, se obtiene la expansión de primer orden del modelo MAR.
Hay que comprobar las condiciones del ajuste, no solo su puntuación predictiva.
Comprobar el signo del sesgo en una región
m=2, π=1/2, m̃=3 y π̃=1/4.
Esperanza de la contribución
E(F̃|X)=3+(1/2)/(1/4)·(2−3)=1.Sesgo
Es 1−2=−1.Producto
[(1/4−1/2)/(1/4)]·(3−2)=−1, igual a la cuenta directa.
Si m̃ se corrige a dos, o π̃ a un medio, el sesgo de esta identidad se anula.
Una propensión demasiado pequeña también amplifica errores y variabilidad.
Comparar tasas suficientes y un caso de frontera
Errores L² de órdenes  y
 .
Producto
Es
 .
Escalar
Multiplicar por √n deja
 , que tiende a cero en probabilidad.
Frontera
Dos errores solo Oₚ(n⁻¹ᐟ⁴) dan Oₚ(n⁻¹ᐟ²), que no garantiza el pequeño o requerido.
Las tasas se suman en el producto; no basta decir ambos aprenden bien.
Dos errores oₚ(n⁻¹ᐟ⁴) sí proporcionan el resto despreciable, con las demás condiciones.
Ahora lo resolvemos de principio a fin.
EJEMPLO RESUELTO 1
Influencia de la media
Para μ=4, calcula ψ(7) de la media.
Objetivo
Para la media, ψ(x)=x−μ.Referencia
Se fija μ=4.Observación
Se evalúa en x=7.Sustituir
ψ(7)=7−4.Calcular
La contribución es tres.
Interpretar
El dato está tres unidades por encima de la media; ψ no es una probabilidad.
ψ(7)=3.
Los valores por encima de la media contribuyen positivamente.
EJEMPLO RESUELTO 2
Varianza de primer orden
Si Var ψ=25, calcula la varianza asintótica sin escalar para n=100.
Escala
Varψ=25 corresponde a la varianza límite de √n(θ̂−θ).Tamaño
n=100.Primer orden
La varianza sin escalar se aproxima por Varψ/n.
Calcular
25/100=1/4.Raíz
El error estándar correspondiente es 1/2.
Alcance
La aproximación usa una expansión válida; no se deduce convergencia de varianzas reales sin controles de momentos.
La aproximación de varianza es 1/4.
Se distingue escala del estimador y escala √n.
Los símbolos que hemos usado
- P
- Distribución de los datos observados bajo el modelo.
- θ(P)
- Parámetro objetivo como función de esa distribución.
- Nuisance o auxiliar
- Parte desconocida que no es el objetivo, como una densidad o regresión.
- ψ_P(x)
- Función de influencia centrada que representa una derivada del parámetro en el modelo.
- Submodelo P_ε
- Familia paramétrica regular que pasa por P al tomar ε=0.
- Score s
- Derivada de logdensidad de un submodelo en cero, en el marco regular.
- Espacio tangente
- Cierre en L²₀(P), el espacio de funciones centradas de cuadrado integrable, de la envolvente lineal de los scores admitidos.
- Influencia eficiente
- Representante de la derivada en el espacio tangente, con varianza mínima en la clase regular pertinente.
Ahora te toca a ti.
Tienes cinco ejercicios. Inténtalos; las pistas te ayudan si te atascas.
Practicar este tema →