Si repetimos una muestra, el estimador cambia. La teoría asintótica estudia qué pasa al aumentar el tamaño: si el error se acerca a cero, a qué velocidad y qué forma tiene tras cambiar de escala. Separaremos esas preguntas antes de construir un intervalo.
Si necesitas repasar:
1. Consistencia significa acercarse al parámetro, sin prometer aún una forma normal
Un estimador θ̂ₙ es una regla aplicada a los datos; el parámetro θ describe la distribución que los genera. Consistencia es 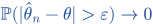 para cada ε>0. La probabilidad se refiere a repetir el muestreo. No garantiza un error pequeño en toda muestra.
Consistencia sola no especifica velocidad, sesgo ni distribución del error. Para una media iid con varianza σ² finita, Chebyshev da P(|X̄−μ|>ε)≤σ²/(nε²), que sí prueba consistencia. Una perturbación que tienda a cero la conserva, aunque cambie por completo las fluctuaciones a otra escala.
Una cota concreta de cercanía
Observaciones iid, μ desconocida, σ²=4; ε=1 y n=100.
Media
Var X̄=4/100.Chebyshev
P(|X̄−μ|>1)≤4/(100·1²)=0,04.Aumentar n
Con ε fijo, esa cota tiende a cero.
La media es consistente bajo estas hipótesis.
La cota no afirma que una muestra concreta tenga error como máximo uno.
Consistente y con un sesgo demasiado grande para √n
Xᵢ∼N(μ,1); θ̂ₙ=X̄+n⁻¹ᐟ⁴.
Consistencia
X̄→μ en probabilidad y n⁻¹ᐟ⁴→0.Escala
√n(θ̂ₙ−μ)=√n(X̄−μ)+n¹ᐟ⁴.Consecuencia
La parte normal centrada tiene varianza uno, pero el desplazamiento n¹ᐟ⁴ aumenta sin límite.
No hay normalidad centrada estándar a escala √n.
En n=10000, el sesgo 0,1 es diez veces el error estándar 0,01 de X̄.
2. La escala convierte un error que desaparece en una cantidad comparable
Rₙ=Oₚ(aₙ), para aₙ>0, significa que Rₙ/aₙ está acotado en probabilidad: para cada tolerancia probabilística hay una cota suficientemente grande que sirve para n grandes.
No son cotas deterministas sobre cada realización.
La escala √n corresponde a errores de orden n⁻¹ᐟ². Si √n(θ̂−θ) converge en ley a una variable no degenerada, el error sin escalar se estrecha. El tamaño del límite y la incertidumbre de θ̂ tienen unidades distintas: una varianza límite V corresponde habitualmente a una aproximación V/n para el estimador, bajo condiciones de momentos cuando se interprete como varianza real.
Comparar restos con la escala elegida
Rₙ=n⁻³ᐟ⁴ determinista.
Multiplicar
√nRₙ=n⁻¹ᐟ⁴.Límite
Tiende a cero.
Notación
Rₙ=oₚ(n⁻¹ᐟ²).
Este resto desaparece en una expansión de primer orden √n.
Para Rₙ=n⁻¹ᐟ⁴ el producto sería n¹ᐟ⁴ y no serviría.
Cuadruplicar una muestra normal
Xᵢ∼N(μ,4); comparar n=25 y n=100.
Varianzas
Son 4/25=0,16 y 4/100=0,04.Errores estándar
Son 0,4 y 0,2.
Escalados
√25(X̄₂₅−μ) y √100(X̄₁₀₀−μ) tienen ambos ley N(0,4).
Aumentar n estrecha el error; reescalarlo permite comparar sus formas.
La normalidad exacta se debe aquí a que las observaciones son normales.
3. La varianza de una media es exacta; el TCL aporta una distribución límite
Para Xᵢ iid de media μ y varianza finita σ², Var(X̄)=σ²/n exactamente. Al expandir la varianza de la suma, las covarianzas entre observaciones distintas son cero. El teorema central del límite añade 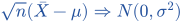 . La flecha compara leyes, sin emparejar caminos.
Con observaciones normales, la media es normal para cada n. Para una población discreta, una media finita sigue siendo discreta y su normalidad es una aproximación. Dependencia o varianza infinita requieren otros teoremas. Si σ²=0, el límite es degenerado y no se divide por cero para estandarizar.
Una variable discreta con aproximación normal
Xᵢ son Bernoulli con p=1/4.
Momentos individuales
E X=p y Var X=p(1−p)=3/16.Media
Var X̄=3/(16n) exactamente.TCL
√n(X̄−1/4) converge a N(0,3/16).
Una media binomial finita no se vuelve literalmente una variable continua.
La aproximación mejora bajo el régimen del teorema, sin fijar aquí un tamaño universal.
Separar la varianza de una observación y la de su media
σ²=25 y n=400.
Observación
Su desviación típica es cinco.
Media
Var X̄=25/400=1/16.Error estándar
√(1/16)=1/4.
El error estándar de la media es σ/√n.
Dividir σ² por √n daría una escala equivocada.
4. Slutsky permite estimar el denominador que desconocemos
Si Zₙ converge en distribución a Z y Aₙ converge en probabilidad a una constante a, Slutsky permite combinar sumas y productos; para cocientes se exige a≠0. La constancia del límite del denominador es esencial en esa versión.
Para una media iid de varianza finita positiva, un estimador Sₙ consistente de la desviación individual σ produce 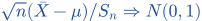 .
Sₙ y SEₙ no representan la misma dispersión.
Usar una desviación estimada en la escala correcta
n=100 y Sₙ=3.
Desviación individual
Sₙ estima σ, no la desviación de X̄.
Error estándar
SEₙ=3/10=0,3.Estadístico
Si X̄−μ=0,6, el valor estandarizado es 0,6/0,3=2.
Se mide el error en unidades de error estándar.
Es equivalente a √100·0,6/3=2.
Un denominador con límite cero no sirve en esta versión
Zₙ⇒N(0,1) y Aₙ=1/n.
Límite
Aₙ→0.Cociente
Zₙ/Aₙ=nZₙ puede crecer en escala.Hipótesis
No se aplica la conclusión de cociente con límite normal dividido por cero.
Antes de estandarizar se comprueba que el límite de la escala sea positivo.
La convergencia de Aₙ por sí sola no basta.
5. Delta es una expansión de Taylor alrededor del parámetro verdadero
Si √n(θ̂−θ)⇒N(0,V) y g es diferenciable en θ, 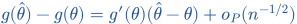 . Por tanto el límite escalado es normal de varianza g′(θ)²V, posiblemente cero. El resto tiene que ser pequeño después de multiplicar por √n, no solo tender a cero sin escala.
En varias dimensiones, si la covarianza límite es Σ y el jacobiano es Dg, la covarianza transformada es DgΣDgᵀ. El teorema deriva en el parámetro verdadero. Para estimar esa covarianza se sustituyen estimaciones consistentes, con continuidad y denominadores no nulos cuando corresponda.
Transformar por el cuadrado lejos de cero
μ=3, σ²=2 y g(x)=x² aplicada a la media.
Derivada
g′(μ)=2μ=6.Cuadrado de la derivada
6²=36.Varianza límite
Vg=36·2=72 para √n(X̄²−9).
La aproximación sin escalar sería 72/n, con el alcance de primer orden correspondiente.
El resultado no es 72 para la varianza de X̄² sin escalar.
Un cociente con dos coordenadas
Media límite (2,4), covarianza límite diagonal (1,4), g(x,y)=x/y.
Gradiente
En (2,4) es (1/4,−1/8).
Multiplicar
V=(1/4)²·1+(−1/8)²·4.Sumar
V=1/16+1/16=1/8.
El denominador verdadero cuatro permite la expansión local.
Si hubiera covarianza no nula, aparecería también el término cruzado.
6. Una pendiente cero pide mirar el término cuadrático
En θ=0, el término lineal desaparece: no desaparece el error, cambia su orden.
No se construye un intervalo normal dividiendo por una varianza delta de primer orden nula.
El mismo cuadrado en el centro cero
Xᵢ∼N(0,4) y θ̂=X̄.
Primer escalado
√nX̄ tiene ley N(0,4).
Cuadrar
nX̄² tiene ley 4χ₁², incluso exactamente en este ejemplo normal.
Orden
X̄² fluctúa a escala 1/n, no 1/√n.
El primer delta daría un límite cero a escala √n y omitiría esta forma no trivial.
El estimador cuadrado es no negativo.
Comparar los dos términos de Taylor
g(x)=x² en θ=2, con error h=0,01.
Lineal
2θh=4·0,01=0,04.Cuadrático
h²=0,0001.Cambio exacto
(2,01)²−4=0,0401.
El término lineal es una buena aproximación aquí porque su pendiente no es cero.
En θ=0, el cambio sería solo 0,0001.
7. La verosimilitud regular y un soporte que cambia pueden producir escalas distintas
El score es la derivada de la logdensidad. Bajo condiciones que permiten derivar la integral, su media es cero y su varianza es la información I(θ). Para un estimador consistente que resuelve el score, si el score en θ dividido por √n tiene límite N(0,I) y la curvatura negativa por observación en la expansión converge a I>0, Taylor y Slutsky dan varianza límite I⁻¹.
Identificación, interior del parámetro y control de la expansión son sustanciales. No se declara eficiente cualquier estimador normal: las cotas comparan estimadores regulares del modelo. Si el soporte depende del parámetro, pueden fallar las condiciones del score y aparecer otra escala.
Bernoulli en un punto interior
p∈(0,1), MLE p̂=X̄.
Score individual
s(x)=(x−p)/(p(1−p)).Información
I(p)=E s²=1/[p(1−p)].Límite
La varianza límite de √n(p̂−p) es p(1−p), igual al TCL de la media.
En p=1/4, I=16/3 y su inversa es 3/16.
Los puntos p=0 y p=1 no se tratan con esta versión interior.
Un máximo uniforme con otra escala
Xᵢ iid uniformes en (0,θ), θ>0; Mₙ=max Xᵢ.
Distribución exacta
P(Mₙ≤m)=(m/θ)ⁿ para 0≤m≤θ.Escalar
Para y≥0 fijo y n>y, P(n(θ−Mₙ)/θ>y)=(1−y/n)ⁿ.Límite
La cola tiende a e⁻ʸ: el límite es exponencial de media uno, a escala n.
El soporte depende de θ y no se aplica la receta regular √n sin comprobarla.
El máximo sigue siendo consistente.
8. Una ley límite no conserva automáticamente las varianzas
Convergencia en distribución controla funciones continuas acotadas. El cuadrado no es acotado: sucesos cada vez más raros y grandes pueden mantener segundos momentos sin aparecer en la ley límite. Para recuperar convergencia de momentos hacen falta controles adicionales, como integrabilidad uniforme de los cuadrados.
Por eso se distingue varianza límite de √n(θ̂−θ), aproximación V/n y varianza exacta de θ̂. Un resto oₚ puede ser despreciable para una distribución límite y tener colas que alteren momentos. Las hipótesis de momentos no se sustituyen por una figura con forma de campana.
Desaparecer en probabilidad y conservar un segundo momento
Zₙ vale n con probabilidad 1/n² y cero en otro caso.
Probabilidad
P(Zₙ>ε)≤1/n² para n grande; Zₙ→0 en probabilidad.Momento
E Zₙ²=n²·1/n²=1.Varianza
E Zₙ=1/n y Var Zₙ=1−1/n²→1, aunque el límite cero tenga varianza cero.
La ley límite no determina el límite de las varianzas.
Las colas de Zₙ² no son uniformemente integrables.
Un caso donde sí podemos calcular la corrección exacta
X̄ normal de media μ y varianza σ²/n.
Momento normal
Var(X̄²)=4μ²σ²/n+2σ⁴/n².Primer orden
Si μ≠0, delta conserva el primer término y el segundo es menor.
Centro cero
Si μ=0, el primer término desaparece y queda 2σ⁴/n².
La cuenta exacta confirma las dos escalas del cuadrado normal.
No se afirma esta identidad exacta para cualquier población con solo segundo momento finito.
9. Un intervalo necesita una escala estimada y un régimen que la justifique
Si el estadístico estandarizado converge a N(0,1) y SEₙ estima correctamente la escala positiva, el intervalo θ̂±z₀,₉₇₅SEₙ tiene cobertura que tiende a 0,95. El valor z es aproximadamente 1,96. No es una promesa de cobertura exacta para toda distribución y todo n.
Con datos normales y σ conocida se obtiene cobertura normal exacta al usar el cuantil exacto. Con σ desconocida y datos normales, el estadístico de la media usa una t de Student con n−1 grados de libertad. La interpretación frecuentista se refiere al procedimiento repetido; no asigna por esa cuenta una probabilidad posterior al parámetro después de fijar los datos.
Construir una aproximación de primer orden
θ̂=10, S=3 y n=100.
Escala
SE=S/√n=3/10=0,3.Margen
Con 1,96, el margen es 1,96·0,3=0,588.Intervalo
[9,412;10,588], con la interpretación y supuestos asintóticos indicados.
El margen usa error estándar, no desviación individual.
No escribimos que esta muestra contenga al parámetro con probabilidad posterior 0,95.
Comprobar un cambio de escala antes de informar
Varianza límite V=36 y n=400.
Sin escalar
La aproximación de varianza es 36/400=0,09.Raíz
SE aproximado=0,3.Informe
La incertidumbre de θ̂ se expresa con 0,3, no con seis ni con 36.
La varianza límite, la varianza del estimador y su error estándar son tres cantidades distintas.
La interpretación como varianza real necesita los controles de momentos pertinentes.
Ahora lo resolvemos de principio a fin.
EJEMPLO RESUELTO 1
Varianza de una media
Si Var X=9 y n=100, calcula Var X̄ y su error estándar.
Datos
La varianza individual es nueve y hay cien observaciones independientes idénticamente distribuidas.
Suma
La varianza de su suma es 100·9=900.Promediar
Dividir la suma por cien divide su varianza por cien al cuadrado.
Varianza
900/10000=0,09.Error estándar
√0,09=0,3.Comprobar
La fórmula σ²/n da 9/100; σ/√n da 3/10.
Varianza 0,09 y error estándar 0,3.
La media usa n, no √n, en la varianza.
EJEMPLO RESUELTO 2
Delta cuadrático
Con μ=2,σ²=3 y g(x)=x², calcula la varianza límite del método delta.
Función
g(x)=x² y el centro verdadero es μ=2.Derivar
g′(x)=2x.Evaluar
g′(2)=4.Cuadrado
La varianza transformada multiplica por 4²=16.Calcular
Vg=16·σ²=16·3=48.Escala
Cuarenta y ocho es la varianza límite para √n(g(X̄)−g(μ)); sin escalar se aproxima por 48/n bajo el alcance indicado.
La varianza límite es 48.
Es la varianza de la escala √n, no la del estimador sin escalar.
Los símbolos que hemos usado
- θ / θ̂_n
- Parámetro verdadero / estimador basado en n observaciones.
- Convergencia en probabilidad
- Para cada ε>0, la probabilidad de desviarse más de ε tiende a cero.
- Convergencia en distribución ⇒
- Convergencia de las distribuciones en el sentido débil pertinente.
- O_p(1)
- Sucesión acotada en probabilidad.
- o_p(1)
- Sucesión que converge a cero en probabilidad.
- Varianza asintótica V
- Varianza de la distribución límite de √n(θ̂_n−θ), cuando se usa esa escala.
- Información I(θ)
- En un modelo regular, esperanza del cuadrado del score por observación.
Ahora te toca a ti.
Tienes cinco ejercicios. Inténtalos; las pistas te ayudan si te atascas.
Practicar este tema →