Si el objetivo suma millones de datos, calcular cada gradiente completo puede ser caro. Un gradiente estocástico usa pocas muestras y cambia precisión por coste de cada paso. Vamos a calcular primero una actualización concreta y después separar qué garantiza la media, qué hace el ruido y cuándo convergen los puntos.
Si necesitas repasar:
1. El objetivo y el coste por paso se definen antes de elegir algoritmo
SGD evalúa una muestra o un grupo pequeño para proponer un paso. Un gradiente completo recorre los N términos, mientras uno individual solo accede a uno.
Comparar métodos exige contar evaluaciones de datos, memoria, comunicación y precisión final. Reducir coste por actualización puede aumentar el número de pasos. Optimizar el objetivo empírico y generalizar a una población son preguntas distintas.
Contar el trabajo con una unidad común
Hay N=1000 términos y se hacen cien actualizaciones.
Completo
Si cada paso usa todos los datos, son 100·1000=100000 gradientes individuales.
SGD
Con una muestra por paso son cien evaluaciones.
Comparar
El coste difiere, pero también puede diferir mucho la precisión alcanzada.
No se declara ganador sin fijar coste y precisión comunes.
El tiempo real también incluye paralelismo, memoria y comunicación.
Una actualización concreta antes de usar esperanzas
x=5,η=1/10 y gradiente observado g=8.
Regla
x nuevo=x−ηg.Producto
ηg=(1/10)·8=4/5.Resultado
5−4/5=21/5.
Un paso usa el gradiente realizado, que puede variar entre ejecuciones.
La esperanza servirá para analizar muchos pasos, no para sustituir el dato observado en esta cuenta.
2. No sesgo significa media correcta condicionada a la historia
Sea ℱₖ la información antes de elegir la muestra del paso k; xₖ ya está determinado por esa historia.
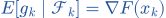 .
El ruido gₖ−∇F(xₖ) tiene media condicional cero.
En un promedio finito, un índice nuevo uniforme da esa identidad exactamente. Para una esperanza de funciones hay que justificar el intercambio de derivación y esperanza. Si el muestreo no es uniforme, se corrigen los pesos o se reconoce que se está siguiendo otro objetivo.
Promediar dos gradientes de un objetivo finito
f₁(x)=(x−1)²/2 y f₂(x)=(x+1)²/2, con índice uniforme.
Individuales
Las derivadas son x−1 y x+1.
Media
Su media es x.
Objetivo
F(x)=(x²+1)/2 tiene gradiente x, el mismo resultado.
El sorteo es no sesgado para el gradiente de este promedio.
Elegir siempre la primera muestra no conserva esa identidad.
Corregir probabilidades de muestreo distintas
Elegimos i=1 con probabilidad 3/4 e i=2 con probabilidad 1/4, pero mantenemos F=(f₁+f₂)/2.
Sin corregir
La media sería (3/4)∇f₁+(1/4)∇f₂.
Corrección
Usamos g=∇fᵢ/(2pᵢ).Media
Σpᵢ∇fᵢ/(2pᵢ)=(∇f₁+∇f₂)/2.
Se recupera no sesgo con probabilidades positivas conocidas.
Los pesos pueden aumentar la varianza; no sesgo no garantiza eficiencia.
3. La media correcta no obliga a que cada paso mejore
Aunque E[gₖ|ℱₖ]=∇F(xₖ), una realización puede apuntar en dirección desfavorable. También un paso grande puede sobrepasar el mínimo sin ruido.
La cota debe valer en el régimen analizado. Colas pesadas, dependencia o varianza creciente necesitan otro control. No se deduce descenso individual ni descenso esperado con cualquier paso de la identidad de no sesgo.
Dos resultados opuestos para un mismo paso
F(x)=x²/2, x=1,η=1/2 y g=x+ξ con ξ=±2 equiprobable e independiente de la historia.
Gradientes
g=3 o g=−1, con media uno y ruido de varianza cuatro.
Nuevos puntos
Son −1/2 o 3/2, con pérdidas 1/8 y 9/8.
Media
La pérdida esperada nueva es 5/8, mayor que la inicial 1/2.
Este paso aumenta incluso la pérdida esperada, sin sesgo del gradiente.
La desigualdad de progreso incluirá un término de ruido que explica el aumento.
Sobrepasar sin ningún ruido
F(x)=x²/2, x=1, g=1 y η=3.
Paso
x nuevo=1−3=−2.Valores
F(1)=1/2 y F(−2)=2.Causa
El gradiente era exacto; el tamaño de paso fue demasiado grande.
Controlar ruido y controlar paso son requisitos distintos.
Para esta cuadrática, la convergencia exacta sin ruido requiere 0<η<2.
4. Un minibatch reduce varianza cuando se controlan las dependencias
La media de b estimaciones condicionalmente independientes con media común y varianza escalar σ² tiene varianza σ²/b. En vectores, la covarianza se divide por b y lo mismo ocurre con su traza, bajo esas hipótesis.
Si las estimaciones dependen entre sí aparecen covarianzas. Para muestreo uniforme sin reemplazo de N>1 valores, con varianza poblacional σ² calculada dividiendo por N, la varianza de su media es σ²(N−b)/(b(N−1)). Es otro esquema; también cuesta más cada actualización cuando aumenta b.
Una media de cuatro gradientes independientes
Cada uno tiene varianza doce y los cuatro son condicionalmente independientes.
Suma
La varianza de sumar es 4·12=48.Promedio
Dividir la suma por cuatro divide la varianza por dieciséis.
Resultado
48/16=3=12/4.
El divisor del promedio se eleva al cuadrado en la varianza.
La regla necesita que las covarianzas cruzadas sean cero, como garantiza la independencia declarada.
Dos datos sin reemplazo eliminan todo el ruido de ese promedio
Población de valores cero y dos, con N=2 y b=2.
Población
La media es uno y su varianza con divisor N es uno.
Sin reemplazo
El lote contiene ambos y su media siempre es uno: varianza cero.
Contraste
Con dos sorteos independientes con reemplazo la varianza sería 1/2.
Se declara cómo se forma el lote antes de usar una fórmula.
No se intercambian los modelos con y sin reemplazo.
5. La suavidad separa progreso y ruido en una desigualdad
Condicionando en la historia y usando no sesgo más la cota de varianza obtenemos 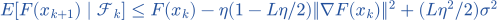 .
Para 0<η≤1/L, el término favorable es al menos η||∇F||²/2, pero permanece el término de ruido. Las esperanzas deben estar bien definidas con los momentos necesarios. La desigualdad es condicional, no una promesa sobre cada realización.
Recuperar la cuenta de las dos ramas
F=x²/2, L=1, x=1,η=1/2,σ²=4.
Inicial
F=1/2 y ||∇F||²=1.Progreso
η(1−η/2)=3/8.Ruido
(η²/2)σ²=1/2.La cota da 1/2−3/8+1/2=5/8, aquí igualdad exacta.
El aumento esperado tiene una explicación cuantitativa.
La cota no elimina el ruido por haber centrado su media.
Sin ruido el mismo paso sí mejora
Misma cuadrática y punto, con g exacto y η=1/2.
Ruido
σ²=0.Cota
F nuevo≤1/2−3/8=1/8.Comprobar
El punto nuevo es 1/2 y su pérdida 1/8.
El término de ruido distingue los dos comportamientos.
La suavidad y el paso permitido justifican esa bajada.
6. Los pasos decrecientes equilibran movimiento acumulado y ruido
En un marco concreto, F es μ-fuertemente convexa y L-suave en ℝᵈ, con mínimo x*, punto inicial de segundo momento finito y ruido condicional centrado de segundo momento ≤σ². Expandir la distancia da 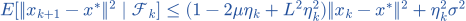 .
Con Σηₖ=∞ y Σηₖ²<∞, esa recurrencia lleva a error cuadrático medio cero. Un paso constante con ruido persistente deja en general una escala residual; sin ruido puede converger exactamente. No se traslada este resultado a cualquier función no convexa.
Una regla suficiente de pasos
μ=L=1 y ηₖ=1/(k+1).
Cota
ηₖ≤μ/L²=1.Series
Σηₖ diverge y Σηₖ² converge.
Conclusión
Con las otras hipótesis, la recurrencia controla el error medio cuadrático y permite su convergencia a cero.
Se han comprobado las condiciones de paso del marco declarado.
Que ηₖ→0 sin comprobar su suma no basta.
Pasos demasiado cortos pueden frenar antes del mínimo
Sin ruido, F=x²/2, x₀=1 y ηₖ=1/(k+2)².
Recurrencia
xₖ₊₁=(1−1/(k+2)²)xₖ.Producto
Hasta K pasos,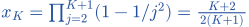 .
Límite
Tiende a 1/2 y no a cero; la suma de pasos es finita.
Una regla decreciente no garantiza por sí sola llegar al mínimo.
El producto se telescopa usando (j−1)(j+1)/j².
7. En no convexidad una cota de gradiente mide estacionariedad
Con F≥ real, L-suavidad, ruido centrado de varianza ≤σ² y paso fijo 0<η≤1/L, sumamos la desigualdad de progreso durante K pasos. Resulta
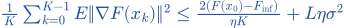 , con punto inicial fijo y las esperanzas pertinentes finitas.
Reducir el lado derecho controla un promedio de gradientes cuadrados. Elegir al azar un índice uniforme independiente entre los visitados da esa misma media esperada. Un gradiente pequeño no certifica mínimo global: puede estar cerca de un máximo o una silla.
Equilibrar el horizonte y el ruido
Para K grande usamos η=c/√K con c>0 y η≤1/L.
Primer término
2(F₀−
)/(ηK) es de orden K⁻¹ᐟ².Segundo
Lησ² también es de orden K⁻¹ᐟ².
Alcance
Se controla estacionariedad esperada promedio, con constantes declaradas.
La conclusión es sobre gradientes y no sobre distancia a un mínimo global.
El paso debe respetar el límite de suavidad.
Gradiente cero en un punto que no minimiza
F(x,y)=x²−y², cerca del origen.
Gradiente
∇F=(2x,−2y), que es cero en (0,0).Direcciones
En el eje x los valores suben y en el eje y bajan.
Clasificar
El origen es una silla, sin mínimo local.
Una condición estacionaria necesita interpretación adicional.
Este ejemplo no cumple la cota inferior global usada en la garantía; ilustra por separado qué significa un gradiente cero.
8. La reducción de varianza usa una referencia y contabiliza su coste
Para un promedio finito y un índice nuevo uniforme, el estimador gᵢ(x)=∇fᵢ(x)−∇fᵢ( )+∇F() es no sesgado. Si x=, los dos gradientes individuales se cancelan y queda el gradiente completo.
Guardar o recalcular la referencia, memoria, momento, curvatura o reparto entre máquinas añade coste y supuestos. Promediar máquinas con cantidades distintas de datos necesita pesos coherentes con el objetivo. El análisis de SGD simple no justifica automáticamente cualquier combinación de estas técnicas.
Comprobar cancelación en una suma pequeña
f₁=(x−1)²/2,f₂=(x+1)²/2 y referencia r.
Diferencia
∇fᵢ(x)−∇fᵢ(r)=x−r en ambas ramas.Completo
∇F(r)=r.Estimador
gᵢ(x)=x−r+r=x en las dos ramas: aquí desaparece todo el ruido.
La igualdad fuera de la referencia es especial de estas dos cuadráticas con igual curvatura.
En funciones generales solo se garantiza la cancelación exacta en x=r.
Ponderar dos máquinas según sus datos
Una máquina tiene diez datos y gradiente medio uno; otra noventa y gradiente medio tres.
Objetivo global
Promedia los cien datos, no las dos máquinas.
Pesos
Son 1/10 y 9/10.
Gradiente
(1/10)·1+(9/10)·3=14/5, frente a la media no ponderada dos.
La comunicación debe conservar el objetivo que se está optimizando.
Otros pesos serían otro promedio, salvo que se justifique otra definición del objetivo.
9. Una cuadrática permite calcular exactamente la escala residual del ruido
En F=x²/2 tomamos gₖ=xₖ+ξₖ, con ruidos independientes de la historia, centrados y de varianza σ².
Si 0<η<2, la media decae geométricamente y el segundo momento satisface E xₖ₊₁²=(1−η)²E xₖ²+η²σ².
Resolver la suma geométrica da un segundo momento límite ησ²/(2−η). Por tanto la pérdida esperada tiende a la mitad de ese valor. No es una cota inferior de cada trayectoria. Un minibatch independiente de tamaño b reemplaza σ² por σ²/b en este modelo.
Calcular la curva del dibujo
x₀=2,η=1/2 y σ²=1.
Factor
(1−η)²=1/4 y el segundo momento límite es 1/3.Segundo momento
E xₖ²=1/3+(4−1/3)(1/4)ᵏ.Pérdida
E F(xₖ)=1/6+(11/6)(1/4)ᵏ→1/6.
La media del punto tiende a cero, pero el ruido conserva pérdida esperada positiva.
El dibujo conecta valores discretos esperados; no muestra una trayectoria simulada.
Cambiar ruido o paso cambia esa escala
Mismo modelo con σ²=1.
Paso menor
η=1/4 da segundo momento límite (1/4)/(7/4)=1/7.Minibatch
Con η=1/2 y b=4 independiente, el segundo momento límite es 1/12.Sin ruido
Con σ²=0 desaparece el término residual y xₖ=(1−η)ᵏx₀→0 si 0<η<2.
La precisión y el coste deben compararse juntos.
La fórmula pertenece al modelo cuadrático declarado, no es una constante universal de SGD.
Ahora lo resolvemos de principio a fin.
EJEMPLO RESUELTO 1
Un paso concreto
Con x=5,η=1/10 y g=8, calcula el siguiente punto.
Datos
x=5,η=1/10,g=8.Regla
x nuevo=x−ηg.Producto
(1/10)·8=8/10=4/5.Mismo denominador
5=25/5.Resta
25/5−4/5=21/5.Comprobar
Es 4,2: se ha restado el gradiente observado ponderado por el paso.
El nuevo punto es 21/5.
La fórmula utiliza el gradiente observado, no su esperanza.
EJEMPLO RESUELTO 2
Minibatch
Si cada gradiente independiente tiene varianza 12, calcula la de la media de 4.
Hipótesis
Cuatro gradientes independientes, cada uno con varianza doce.
Suma
La varianza total de la suma es 4·12=48.Promedio
La media divide esa suma por cuatro.
Escalado
La varianza se divide por 4²=16.Resultado
48/16=3.Comprobar
Equivale a σ²/b=12/4.Si hubiera covarianzas no nulas, se añadirían antes de dividir.
La varianza es 3.
Equivale a 12/4.
Los símbolos que hemos usado
- F(x)
- Objetivo esperado o promedio finito que se minimiza.
- f(x;ξ)
- Pérdida individual dependiente de una muestra.
- ℱₖ
- Información disponible antes de la muestra del paso k.
- gₖ
- Estimación del gradiente en la iteración.
- ηₖ>0
- Longitud de paso.
- Minibatch
- Promedio de varias estimaciones en un paso.
- Varianza condicional
- Dispersión de la estimación después de fijar la información previa.
Ahora te toca a ti.
Tienes cinco ejercicios. Inténtalos; las pistas te ayudan si te atascas.
Practicar este tema →