Un modelo puede acertar los datos que vio y fallar en datos nuevos. La teoría de aprendizaje pregunta cuánto puede diferir ese rendimiento y con qué probabilidad. Empezaremos con pérdidas de ceros y unos, construiremos una cota para un modelo fijo y después veremos cómo permite elegir entre varios.
Si necesitas repasar:
1. El riesgo de la muestra y el de la distribución son cantidades distintas
Suponemos observaciones z₁,…,zₙ independientes y con la misma distribución D: IID. Fijamos de antemano una clase H finita, no vacía, y pérdidas medibles 0≤ℓ(h,z)≤1. En clasificación, la pérdida cero–uno vale uno al fallar y cero al acertar.
El riesgo poblacional 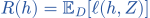 promedia sobre un dato nuevo de D. El empírico
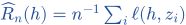 promedia la muestra. Entrenar suele reducir el segundo; el primero es la cantidad que queremos controlar.
Contar errores de una muestra
Un clasificador falla una de cuatro observaciones.
Pérdidas
Podrían ser (0,0,1,0).
Media
R̂=1/4.Alcance
No sabemos todavía la tasa de fallo en toda la distribución.
El número observado es riesgo empírico.
El tamaño cuatro y la hipótesis de muestreo influyen en cuánta confianza merece.
Una pérdida no tiene que ser solo cero o uno
Valores observados 0,1/5,3/10,1/2.
Sumar
0+0,2+0,3+0,5=1.Dividir
R̂=1/4.Hipótesis
Todos están en [0,1], así que este rango sigue siendo compatible con la cota elemental.
La garantía controla una media de pérdidas acotadas.
Una pérdida cuadrática sin cota no cumple automáticamente esa misma hipótesis.
2. La confianza se refiere a repetir la extracción de muestras
Antes de observar datos, R̂ es aleatorio porque depende de la muestra. Para h fijo, su esperanza es R(h), pero una muestra concreta puede quedar por encima o debajo. Una ley asintótica no da sola un margen a tamaño finito.
Una garantía de confianza 1−δ significa que el evento indicado ocurre con al menos esa probabilidad sobre las muestras. No significa que cada predicción nueva tenga error menor que el margen ni transforma el evento en certeza después de entrenar.
Cero errores no prueba riesgo cero
Un predictor fijo tiene riesgo 1/5 y evaluamos cinco datos IID.
Acertar cada uno
Probabilidad 4/5.
Todos correctos
Probabilidad (4/5)⁵=0,32768.Resultado observado
En esas muestras R̂=0, aunque R=1/5.
Un historial corto perfecto puede ocurrir con un riesgo real positivo.
El ejemplo supone el predictor fijo antes de extraer esos datos.
Ver la variabilidad de una media
Dos pérdidas independientes, cada una Bernoulli de probabilidad 1/2.
R̂=0
Ambas cero: probabilidad 1/4.
R̂=1/2
Una de cada: probabilidad 1/2.
R̂=1
Ambas uno: probabilidad 1/4; la media de R̂ sigue siendo 1/2.
Insesgado no significa exacto en cada muestra.
Aquí la desviación supera 1/4 en la mitad de las muestras.
3. Hoeffding controla un modelo fijado antes de ver la muestra
Para un h fijo y las hipótesis anteriores, 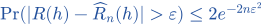 . El factor dos controla ambas direcciones. Para un margen fijo, aumentar n reduce esta cota.
Elegir después el modelo más favorable entre muchos requiere algo más: la garantía de un h prefijado no se aplica automáticamente a una selección que usó esos mismos datos. Primero construiremos un evento simultáneo.
Una cota informativa
n=200 y ε=1/10, para h fijo.
Exponente
−2·200·(1/10)²=−4.Fallo de la cota
Probabilidad de desviación mayor que 0,1 como máximo 2e⁻⁴≈0,03663.
Confianza
El evento |R−R̂|≤0,1 tiene probabilidad al menos 0,96337.
Es una desigualdad probabilística, no la probabilidad exacta del problema.
El riesgo de una predicción individual no es 0,1 por esta cuenta.
Una cota puede ser vacía
n=25 y ε=1/10.
Evaluar
2e⁻¹ᐟ²≈1,213.Probabilidad
Ya sabemos que cualquier probabilidad es como máximo uno.
Interpretar
Esta elección no da un control útil adicional; no informamos confianza negativa.
Una cota correcta puede ser poco informativa con pocos datos.
No se fuerza una interpretación numérica que la desigualdad no da.
4. La unión controla toda la clase sin independencia entre modelos
El evento uniforme falla si falla para alguno de los M=|H| modelos. La probabilidad de una unión no supera la suma: 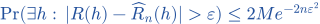 .
Para 0<δ<1 elegimos 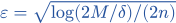 , con log natural. Con probabilidad al menos 1−δ, todos los modelos de H cumplen el margen a la vez. No se exige que sus eventos de error sean independientes.
Calcular un margen uniforme
M=100, δ=1/20 y n=1000.
Logaritmo
2M/δ=4000.Margen
ε=√(log4000/2000)≈0,0644.Evento
Con probabilidad al menos 0,95, el margen vale simultáneamente para los cien modelos.
Ahora podemos seleccionar entre ellos usando la muestra dentro de ese evento.
La clase se fijó independientemente de esos datos.
Los eventos pueden coincidir
Dos clasificadores constantes predicen cero y uno ante etiquetas binarias.
Pérdidas
Para cada observación sus pérdidas son complementarias.
Desviaciones
La desviación absoluta de uno respecto a su riesgo coincide con la del otro.
Unión
Sumar sus probabilidades puede contar dos veces el mismo fallo; sigue siendo una cota superior válida.
La unión es segura aunque sea poco ajustada.
La independencia requerida por Hoeffding es entre observaciones, no entre estos dos modelos.
5. El evento simultáneo permite elegir y acotar el riesgo excesivo
Sea ĥ un minimizador exacto del riesgo empírico en H. En el evento uniforme, para cualquier h∈H,  . Cada desigualdad tiene una razón: garantía, mínimo empírico y garantía otra vez.
La comparación es con el mejor modelo de esa clase, no con cualquier predictor imaginable. Si el algoritmo aproxima el mínimo empírico con error η≥0, se añade η a 2ε. Error de optimización, elección de clase y generalización son cuestiones distintas.
El mejor entrenamiento puede no tener el mejor riesgo real
Dos modelos con R̂_A=0,10, R̂_B=0,12 y margen uniforme ε=0,03.
Seleccionar
ERM elige A.
Riesgos compatibles
Podrían ser =0,13 y
 =0,09: ambos respetan el margen.
Comparar
El exceso de A es 0,04, inferior a 2ε=0,06.
La garantía limita la diferencia sin asegurar que el orden observado sea el real.
Estos riesgos ilustran un evento compatible; normalmente no los conocemos.
Añadir error del algoritmo
Margen ε=0,03 y optimización empírica con η=0,02.
Mínimo aproximado
R̂(ĥ)≤min R̂+0,02.Generalización
Se añaden los dos márgenes de 0,03.
Resultado
R(ĥ)≤min_H R+0,08 en el evento uniforme.
Reducir error de optimización no elimina la incertidumbre estadística.
La cota no incluye automáticamente modelos ajenos a H.
6. Más datos, más modelos y más confianza comparten la fórmula
Para M y δ fijos, ε escala como n⁻¹ᐟ². Cuadruplicar n lo divide por dos. Para un margen deseado ε basta 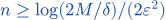 , redondeando al entero superior.
Aumentar M sube la cota; puede mejorar la aproximación de la clase y aumentar su complejidad a la vez. Reducir δ pide más confianza y también sube el margen a n fijo. Estas son condiciones suficientes de peor caso, no un número exacto de datos que necesite toda tarea.
Un tamaño suficiente
M=100, δ=1/20 y margen uniforme deseado 1/20.
Sustituir
n≥log4000/[2·(1/20)²]=200log4000.Evaluar
200log4000≈1658,81.Entero
Bastan n≥1659 según esta cota.
Este objetivo es controlar desviación uniforme por 0,05.
Un exceso ERM de 0,05 exigiría controlar cada desviación por 0,025 y otro tamaño.
Comparar cuatro veces más datos
M y δ se mantienen.
Antes
ε_n=√(log(2M/δ)/(2n)).Después
ε_4n=√(log(2M/δ)/(8n)).Cociente
ε_4n=ε_n/2.
La ganancia de esta fórmula es de raíz cuadrada.
No se cambia simultáneamente M o δ al hacer esta comparación.
7. Una clase infinita puede tener una complejidad controlada
Con infinitos modelos no se introduce M=∞ en la misma cota esperando un número finito. En clasificación binaria, herramientas como dimensión VC y funciones de crecimiento controlan cuántos patrones de etiquetas puede producir una clase.
La dimensión VC es el máximo número de puntos que puede etiquetarse de todas las formas mediante la clase. Otros problemas requieren otras complejidades y condiciones de medibilidad. Contar parámetros no reemplaza automáticamente ese análisis.
Umbrales en la recta
 (x)=1 si x≥t y cero en otro caso, con t real.
Un punto
Se puede etiquetar cero o uno moviendo t.
Dos ordenados
Para x₁<x₂ se obtienen 00,01,11, pero no 10.VC
La dimensión es uno, aunque haya infinitos umbrales.
Cardinalidad infinita no equivale a complejidad infinita en todos los sentidos.
La conclusión usa esta familia de umbrales concretos.
Todas las etiquetas en un conjunto finito
Dominio con d puntos y todos sus 2ᵈ clasificadores binarios.
Realizar
Cada patrón de etiquetas está incluido.
Separar
Los d puntos se pueden fragmentar de todas las formas.
Dimensión
VC=d; no hay d+1 puntos distintos en ese dominio.
La riqueza de la clase depende de qué decisiones permite realizar.
Esto no certifica la dimensión VC de una red arbitraria contando solo pesos.
8. Repetición y cambio de distribución pueden romper las hipótesis
IID pide independencia y la misma distribución que se usará al definir el riesgo nuevo. Datos repetidos, dependencia temporal o cambios de población necesitan otro análisis. No se arreglan poniendo un n mayor en la fórmula original.
La evaluación práctica complementa la garantía con separación de datos y controles de selección. Probar modelos indefinidamente sobre la misma prueba introduce adaptación. Se comunica el evento, las hipótesis y su alcance junto al número calculado.
Copiar un dato no crea observaciones independientes
Todas las pérdidas observadas son la misma variable Y, Bernoulli de probabilidad 1/2.
Marginal
Cada posición por separado tiene media 1/2.
Promedio
R̂_n=Y para cualquier n.Desviación
|R̂_n−1/2|=1/2 siempre, sin disminuir con las copias.
La independencia no se sustituye por contar filas repetidas.
El ejemplo conserva la distribución marginal y cambia su dependencia.
Entrenar y evaluar en poblaciones distintas
Entrenamiento: siempre etiqueta cero. Evaluación: siempre etiqueta uno. Predictor: constante cero.
Entrenamiento
R̂=0 y el riesgo bajo esa misma distribución es cero.
Evaluación nueva
El riesgo en la otra distribución es uno.
Hipótesis
No hay contradicción con la garantía IID para una única D.
La fórmula no prometía transferir a cualquier población distinta.
Bajo la misma D, el tamaño de muestra y la complejidad seguirían importando.
Ahora lo resolvemos de principio a fin.
EJEMPLO RESUELTO 1
Error de entrenamiento y margen
Si R̂=1/10 y una garantía da |R−R̂|≤1/5, acota R por arriba.
Dato empírico
R̂=1/10.Evento
La garantía indicada es |R−R̂|≤1/5.Una dirección
R−R̂≤1/5.Sumar
R≤1/10+1/5=3/10.Alcance
Es una cota superior en el evento de la garantía.
Comprobar
No es una igualdad ni una certeza fuera de ese evento.
R≤3/10 en el evento de la garantía.
No es igualdad ni una certeza fuera de ese evento.
EJEMPLO RESUELTO 2
Aumentar la muestra
Con clase y confianza fijas, ¿cómo cambia ε si n se multiplica por 4?
Fórmula
Con clase y confianza fijas, ε_n=c/√n para una constante c.
Nuevo tamaño
Pasamos de n a 4n.
Raíz
√(4n)=2√n.Dividir
ε_4n=c/(2√n)=ε_n/2.Resultado
El margen se reduce a la mitad.
Comprobar
No se ha alterado el término de complejidad ni la confianza.
El margen se reduce a la mitad.
Este cálculo no cambia el término de complejidad.
Los símbolos que hemos usado
- H
- Clase de hipótesis o modelos candidatos.
- ℓ(h,z)
- Pérdida del modelo h en una observación z.
- R(h)
- Esperanza poblacional de la pérdida.
- R̂ₙ(h)
- Promedio de pérdida en la muestra de entrenamiento.
- δ
- Cota de probabilidad de fallo de una garantía.
- ε
- Margen que acota la diferencia entre riesgos.
- Convergencia uniforme
- Control simultáneo de la desviación para todos los modelos de la clase.
Ahora te toca a ti.
Tienes cinco ejercicios. Inténtalos; las pistas te ayudan si te atascas.
Practicar este tema →