La incógnita puede ser una curva completa, no un solo número. Una previa describe qué funciones considera posibles el modelo y los datos la reponderan. Empezaremos construyendo una previa y una actualización escalar; después pasaremos a procesos gaussianos e infinitas coordenadas.
Si necesitas repasar:
1. Una previa sobre funciones es una medida, no una densidad de Lebesgue infinita
Elegimos un espacio medible de funciones y una probabilidad Π sobre él. Con verosimilitud L(y|f) medible y normalizador Z=∫L(y|f)dΠ(f) positivo y finito, la posterior es 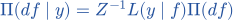 . No se presupone una densidad respecto de una medida de Lebesgue infinita como si hubiera finitas coordenadas.
El soporte, la regularidad y las restricciones del objeto importan. Una previa gaussiana para una regresión puede admitir valores negativos; eso no la convierte en una previa válida directamente sobre densidades. El mecanismo de observación también forma parte del modelo.
Una función con infinitos coeficientes aleatorios
En [0,1], eₖ(x)=√2sin(kπx) y 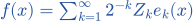 , con Zₖ normales estándar independientes.
Coeficientes
Cada término tiene varianza de coeficiente 4⁻ᵏ; se entiende la suma sobre k≥1.
Convergencia
EΣ2⁻ᵏ|Zₖ| es finita. Como |eₖ|≤√2, la serie converge absolutamente y uniformemente casi seguramente.
Objeto
Define una función continua aleatoria, con E||f||₂²=Σ4⁻ᵏ=1/3.
Hay infinitas coordenadas, pero su tamaño se controla para definir una función.
La continuidad se ha justificado por la suma uniforme, no solo por llamar gaussiano al objeto.
Convertir una función en una densidad
W es una función aleatoria continua en [0,1].
Positividad
eᵂ⁽ˣ⁾ es estrictamente positiva.
Normalizar
f(x)=eᵂ⁽ˣ⁾/∫₀¹eᵂ⁽ᵘ⁾du está bien definida: la integral es positiva y finita por continuidad y compacidad.
Área
f≥0 e ∫f=1; en general f ya no es un proceso gaussiano.
La restricción de densidad se impone con una construcción explícita.
La actualización de esta densidad no hereda automáticamente la conjugación de una observación gaussiana de W.
2. Un proceso gaussiano se define comprobando todos los grupos finitos de puntos
f∼GP(m,k) significa que (f(x₁),…,f(xᵣ)) es normal multivariante para cualquier colección finita, con medias m(xᵢ) y covarianzas k(xᵢ,xⱼ). Se admiten normales degeneradas. Las marginales deben ser compatibles al eliminar o permutar puntos.
El núcleo debe ser simétrico y semidefinido positivo: Σaᵢaⱼk(xᵢ,xⱼ)≥0 para toda elección finita. Esa cantidad es la varianza de Σaᵢf(xᵢ). Que las entradas diagonales sean positivas no basta; las covarianzas cruzadas pueden hacer imposible la matriz.
Una matriz con diagonales positivas que no es válida
Matriz de filas (1,2) y (2,1).
Combinación
Tomamos a=(1,−1).Cuadrático
aᵀKa=1+1−2·2=−2.Imposibilidad
Sería la varianza de f(x₁)−f(x₂), que no puede ser negativa.
No es una matriz de covarianza admisible.
Revisar solo las dos varianzas uno habría pasado por alto el fallo.
Un núcleo válido que permite degeneración
k(x,y)=1+xy.
Construcción
f(x)=U+Vx, con U,V normales independientes de varianza uno.Covarianza
Cov(f(x),f(y))=1+xy.Positividad
Σaᵢaⱼk(xᵢ,xⱼ)=(Σaᵢ)²+(Σaᵢxᵢ)²≥0.
Es un GP de rango finito que sirve para entender la definición.
Con muchos puntos su matriz puede ser singular sin dejar de ser válida.
3. Normalidad finita no demuestra continuidad de la función
Para obtener trayectorias continuas o diferenciables hay que controlar incrementos y aplicar criterios apropiados, como continuidad de Kolmogorov con momentos y exponentes suficientes respecto de la dimensión del dominio. El nombre gaussiano describe leyes finitas, no toda regularidad.
Cambiar el núcleo cambia la relación entre puntos próximos. Un modelo con valores independientes en cada punto puede tener marginales perfectamente normales y no admitir una versión continua. Una observación de pocos puntos tampoco prueba la suavidad entre ellos.
Continuo y sin derivada
El browniano tiene núcleo k(s,t)=min(s,t).
Marginales
Sus vectores finitos son gaussianos.
Regularidad
Tiene una versión continua y localmente Hölder para exponentes menores que 1/2.
Límite
Casi seguramente no es diferenciable en ningún punto.
Gaussiano no significa suave de cualquier orden.
La regularidad es un teorema sobre el proceso, distinto de calcular una covarianza.
Independencia entre puntos impide continuidad aquí
k(x,y)=1 si x=y y cero en otro caso, en [0,1].
Validez
Las matrices son de covarianza de valores normales independientes, identificando puntos repetidos.
Aproximación
Para puntos distintos xₙ→x, f(xₙ)−f(x) tiene ley N(0,2).Fallo
La probabilidad de una diferencia grande no tiende a cero; no hay continuidad en probabilidad ni una versión de caminos continuos.
Un núcleo válido puede describir un objeto espacial demasiado irregular para una curva continua.
No se cambia esa conclusión trazando líneas entre unas pocas muestras.
4. Completar un cuadrado explica la actualización escalar
La posterior es proporcional a exp(−f²/(2τ²)−(y−f)²/(2σ²)). El coeficiente cuadrático da precisión 1/τ²+1/σ².
Completar el cuadrado produce 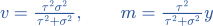 . La ganancia está entre cero y uno. Con media previa m₀, la media es m₀+ganancia·(y−m₀). Varianzas cero requieren tratar leyes degeneradas, no dividir por cero.
Actualizar con un dato más preciso que la previa
τ²=4, σ²=1 y y=3.
Ganancia
4/(4+1)=4/5.Media
m=(4/5)·3=12/5.Varianza
v=4·1/5=4/5.
El dato desplaza la media hacia tres y reduce la varianza previa cuatro.
La media no llega exactamente al dato porque el ruido sigue siendo positivo.
Una media previa distinta de cero
m₀=1, τ²=1, σ²=1 y y=5.
Ganancia
Es 1/2.
Desplazamiento
El dato se aparta cuatro de la media previa.
Posterior
m=1+(1/2)·4=3 y v=1/2.
La contracción se hace hacia la media previa, que no siempre es cero.
No se usa y/2 sin añadir el centro previo.
5. Las covarianzas trasladan una actualización a muchos puntos
En entradas observadas X y entradas objetivo X*, con ruido independiente σ²I y parámetros del núcleo fijados, definimos C=KXX+σ²I. La media posterior es 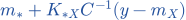 y la covarianza latente
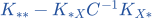 . Se obtienen condicionando una normal conjunta.
Con σ²>0, C es positiva definida aunque KXX sea singular. Se resuelve un sistema, normalmente por Cholesky, en vez de formar una inversa innecesaria. La covarianza posterior no depende de los valores de y con núcleo y ruido fijados; sí depende de ubicaciones y parámetros. La media depende también de y.
Dos mediciones de la misma señal con ruido independiente
f tiene previa N(0,1); y₁=2,y₂=4 y cada ruido tiene varianza uno.
Precisión
La posterior suma 1+1+1=3.Media
m=(2+4)/3=2.Varianza
v=1/3; los dos ruidos siguen siendo independientes aunque las entradas coincidan.
La matriz de ruido añade I en los índices de observaciones, no una matriz de unos por coincidir sus entradas.
Sin ruido y con observaciones repetidas incompatibles no se usa esta fórmula como si σ² fuera positivo.
Un sistema pequeño con entradas relacionadas
K tiene filas (1,1/2),(1/2,1), σ²=1/2 y y=(2,0), con media previa cero.
Sistema
C tiene filas (3/2,1/2),(1/2,3/2); resolver Cα=y da α=(3/2,−1/2).Media latente
Kα=(5/4,1/4).Covarianza
K−KC⁻¹K tiene filas (5/16,1/16),(1/16,5/16).
Observar el segundo valor también informa el primero mediante la covarianza.
La matriz posterior es semidefinida positiva y sus varianzas son menores que uno.
6. Predecir otra medición añade ruido a la incertidumbre de la función
La posterior de f(x*) es incertidumbre latente. Para y*=f(x*)+ε*, con ruido nuevo independiente de varianza σ², la varianza predictiva es Var(f(x*)|y)+σ². La covarianza latente se reduce en el orden semidefinido al condicionar bajo el modelo fijo, pero el ruido de una medición nueva no se elimina.
Si amplitud, longitud de correlación o varianza de ruido son desconocidas, fijarlas en un valor estimado no equivale a integrarlas en un modelo jerárquico. La ley de varianza total añade tanto la media de varianzas condicionales como la varianza de medias condicionales. Esa incertidumbre adicional debe formar parte del procedimiento que se informa.
Una observación y una franja puntual
k(x,x′)=exp(−(x−x′)²/2); observar y=2 en x=0 con σ²=1/4.
Media
m(x)=(8/5)exp(−x²/2).Varianza latente
v(x)=1−(4/5)exp(−x²).En x=0 vale 1/5.Nueva medición
En x=0 su varianza predictiva es 1/5+1/4=9/20.
La franja latente se estrecha cerca de la observación, sin anular el ruido.
Los intervalos punto a punto del dibujo no forman automáticamente una banda simultánea.
Integrar un hiperparámetro puede añadir variación
Dos valores auxiliares equiprobables producen medias posteriores −1 y 1, cada una con varianza 1/4.
Promedio de varianzas
Es 1/4.
Varianza de medias
La media global es cero y la varianza de las dos medias es uno.
Total
La mezcla tiene varianza 1/4+1=5/4.
Informar solo 1/4 olvidaría la incertidumbre entre los dos ajustes.
La mezcla no tiene por qué ser una única normal.
7. Concentrar la posterior alrededor de la verdad requiere soporte y datos informativos
Contracción pregunta si Π(||f−f₀||>Mεₙ|datos) se hace pequeña, en una distancia y un régimen declarados. La respuesta depende de la previa, la posición de f₀ respecto de su soporte y regularidad, las observaciones y pruebas estadísticas disponibles. No se deduce una tasa universal porque la previa sea gaussiana.
Las probabilidades de bolas pequeñas y el espacio de Hilbert reproductor intervienen en resultados para previas gaussianas. Son teoremas específicos de modelos de regresión, densidad u otros; no basta invertir una matriz finita. También existen previas no gaussianas y construcciones distintas para densidades.
La posterior no crea masa donde la previa prohíbe
La previa sobre funciones continuas obliga a f(0)=0 y la verdad es f₀≡1.
Distancia
Toda función permitida está al menos a uno de f₀ en norma suprema.
Bola
La bola de radio 1/2 alrededor de f₀ tiene masa previa cero.
Posterior
Reponderar por una verosimilitud con normalizador válido mantiene esa masa en cero.
No hay contracción en esa bola bajo ese modelo.
La afirmación depende de la norma y restricción indicadas.
Medir muchas veces una parte no observa todas las demás
Una previa tiene coeficientes independientes y solo se observan los primeros m, con m fijo.
Actualización
Los datos informan los coeficientes incluidos en la verosimilitud.
Cola independiente
Los coeficientes k>m conservan su distribución previa.Conclusión
Reducir mucho el ruido de las primeras mediciones no demuestra concentración arbitraria de toda la cola.
El diseño de observación decide qué información entra.
Si m crece con los datos, el problema es otro y necesita una cota de cola.
8. Masa creíble y cobertura repetida son probabilidades diferentes
Un conjunto creíble de nivel 95 % tiene esa masa bajo la posterior condicionada al modelo. Cobertura frecuentista fija una verdad y repite el muestreo para contar cuántos conjuntos la contienen. En general no son la misma afirmación.
En dimensión infinita no se traslada automáticamente Bernstein–von Mises a toda la función. Existen contraejemplos, y existen resultados específicos para ciertos funcionales o topologías bajo condiciones. Un dibujo de una franja posterior no prueba cobertura global ni elimina un sesgo de regularización.
Interpretar un intervalo posterior escalar
Posterior N(2,1/2).
Escala
La desviación posterior es 1/√2.
Intervalo
Con el cuantil normal exacto z₀,₉₇₅, el intervalo 2±z₀,₉₇₅/√2 tiene masa posterior 0,95.
Alcance
Es una afirmación condicionada al modelo y los datos, no una prueba automática de cobertura repetida para cada verdad fija.
Se declara qué probabilidad se está usando.
1,96 es una aproximación del cuantil exacto.
Un prior muy concentrado puede conservar sesgo
Previa N(0,τ²) con τ² muy pequeña frente al ruido y una verdad fija lejos de cero.
Ganancia
τ²/(τ²+σ²) es pequeña.
Media posterior
Incluso datos próximos a la verdad se contraen fuertemente hacia cero.
Cobertura
La masa posterior nominal no garantiza que el intervalo cubra bien esa verdad en muestras repetidas.
Una posterior estrecha puede reflejar una restricción previa fuerte.
La conclusión no es que toda previa concentrada falle; se compara su escala y localización con el problema.
9. Un modelo de secuencias permite actualizar infinitas coordenadas sin una matriz infinita inversa
Consideremos observaciones Yₖ=θₖ+n⁻¹ᐟ²Zₖ para k≥1, con Zₖ normales estándar independientes, y previa θₖ independientes N(0,τₖ²). Es un experimento de coordenadas; el ruido blanco infinito no se trata como un vector de ℓ².
La conjugación coordenada a coordenada da 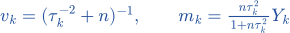 . Las posteriores son compatibles e independientes en este modelo diagonal. Para reconstruir una posterior con valores ℓ², comprobamos suma de varianzas finita y media posterior en ℓ², no solo existencia de cada marginal.
Bajas y altas frecuencias con distinta contracción
τₖ²=1/k² y n=9.
Modo uno
Ganancia 9/(9+1)=9/10 y varianza 1/10.Modo tres
Ganancia 9/(9+9)=1/2 y varianza 1/18.Modo nueve
Ganancia 9/(9+81)=1/10 y varianza 1/90.
La previa reduce más los coeficientes altos en este modelo.
Las ganancias no son probabilidades de que un coeficiente sea distinto de cero.
Verificar que el objeto posterior es una secuencia cuadrado-sumable
τₖ²=1/k², n fijo y verdad θ₀∈ℓ².
Varianzas
Σvₖ=Σ1/(n+k²)≤Σ1/k²<∞.Media aleatoria
La parte de señal de m tiene norma controlada por ||θ₀||; la energía media de su ruido es Σn/(n+k²)²<∞.
Reconstruir
m∈ℓ² casi seguramente bajo esa verdad y la posterior gaussiana tiene valores en ℓ².
La condición de suma completa la definición infinita.
Y mismo sigue sin ser un vector ℓ² por su ruido blanco.
10. La dispersión posterior no es todo el error respecto de la verdad
En el ejemplo τₖ²=1/k², la traza posterior Vₙ=Σ1/(n+k²) está entre π/(2√n)−1/n y π/(2√n), por comparación con integrales. Es de orden n⁻¹ᐟ²; su raíz tiene orden n⁻¹ᐟ⁴. Esa es una escala de dispersión posterior en ℓ².
La media posterior tiene sesgo frecuente 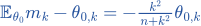 . Su ruido también contribuye al error. Una contracción alrededor de θ₀ requiere controlar ambas cosas además de Vₙ, con regularidad de la verdad y la previa pertinentes. La reducción de traza por sí sola no demuestra cobertura de una bola creíble.
Una cota de dispersión para muchas coordenadas
τₖ²=1/k² y n=100.
Integral superior
V₁₀₀≤π/(2·10)=π/20.Cota inferior
V₁₀₀≥π/20−1/100.Interpretación
La energía posterior alrededor de su media está controlada, sin confundir la media con la verdad.
Las cotas usan la suma infinita y no una truncación sin error de cola.
La raíz de V mide una distancia cuadrática media, no V directamente.
Un modo todavía dominado por la previa
n=100 y un coeficiente verdadero en k=20.
Ganancia
n/(n+k²)=100/500=1/5.Sesgo
E m₂₀−θ₀,₂₀=−(4/5)θ₀,₂₀.Conclusión
Una varianza posterior pequeña en ese modo no elimina una señal verdadera grande que la previa contrae.
El error depende también de cómo se reparte la verdad entre frecuencias.
Al aumentar n con k fijo la ganancia tiende a uno; el problema infinito incluye modos k que crecen.
Ahora lo resolvemos de principio a fin.
EJEMPLO RESUELTO 1
Una observación
Con τ²=1,σ²=1,y=4, calcula media y varianza posterior.
Modelo
Previa N(0,1), ruido N(0,1) independiente y observación y=4.Precisión
La precisión posterior es 1+1=2.Varianza
Su inversa es 1/2.
Media
La precisión ponderada del dato es cuatro, así m=(1/2)·4=2.
Posterior
La ley resultante es N(2,1/2).
Comprobar
La varianza latente es menor que la previa uno; la media queda entre cero y cuatro.
Posterior N(2,1/2).
La incertidumbre es menor que la previa.
EJEMPLO RESUELTO 2
Más precisión observacional
Con τ²=4,σ²=1,y=5, calcula la media posterior.
Datos
τ²=4, σ²=1 y y=5.Ganancia
τ²/(τ²+σ²)=4/5.Media
m=(4/5)·5=4.Varianza si se pide
v=4·1/5=4/5.Interpretar
El dato pesa más que la previa porque su ruido es menor que la varianza previa.
Alcance
La cuenta fija las varianzas y no integra hiperparámetros desconocidos.
La media posterior es 4.
Se acerca al dato, manteniendo contracción hacia cero.
Los símbolos que hemos usado
- Π
- Distribución previa sobre el objeto funcional desconocido.
- f∼GP(m,k)
- Proceso gaussiano con media m y núcleo de covarianza k.
- Semidefinido positivo
- Toda forma cuadrática de una matriz de covarianza finita es no negativa.
- Función latente
- Señal desconocida, distinta del ruido de medición.
- Verosimilitud L(y|f)
- Modelo de observación de datos y si la función fuera f.
- Posterior
- Distribución actualizada al observar los datos.
- Contracción
- Concentración posterior en vecindades de la verdad bajo una distancia y un esquema de muestras crecientes.
- Conjunto creíble
- Conjunto que recibe una probabilidad posterior especificada, condicionado a los datos y al modelo.
Ahora te toca a ti.
Tienes cinco ejercicios. Inténtalos; las pistas te ayudan si te atascas.
Practicar este tema →