En un sistema enorme suele ser fácil multiplicar una matriz por un vector y difícil guardar su inversa. Los métodos de Krylov construyen la solución a partir de esas multiplicaciones. Resolveremos un sistema de dos componentes a mano para ver qué significan sus pasos y por qué precondicionar puede ahorrar trabajo.
Si necesitas repasar:
1. El residuo comprueba las ecuaciones y la condición relaciona ese fallo con el error
El tamaño del residuo no dice por sí solo el tamaño del error.
Una κ grande puede hacer poco informativa la cota, aunque el residuo sea pequeño. El algoritmo usa productos Av y una regla de parada que fija norma, escalas y tolerancia.
Un residuo pequeño y un error grande
A=diag(1,1/1000), b=(1,1/1000), aproximación x=(1,0).
Solución
x*=(1,1).Residuo
b−Ax=(0,1/1000), norma 0,001.Error
x*−x=(0,1), norma uno.
La dirección débil puede ocultar un error importante.
Aquí la inversa multiplica esa dirección por mil.
Un producto no requiere inversa
A=[[2,−1],[−1,2]] y v=(3,1).
Primera fila
2·3−1=5.Segunda
−3+2·1=−1.Resultado
Av=(5,−1).
Cada producto usa las conexiones de la matriz.
En una matriz dispersa se aprovechan sus entradas no nulas.
2. El espacio de Krylov reúne las direcciones generadas por la matriz
El espacio 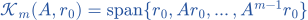 contiene todas sus combinaciones lineales. La búsqueda se hace en x₀+
 , no solo en uno de los vectores de la lista.
Hay m generadores, pero su dimensión puede ser menor.
Si los productos generan un subespacio invariante, un método apropiado puede terminar antes de la dimensión total. Dependencia exacta y pérdida numérica de independencia se tratan de forma distinta.
Construir dos direcciones
A=diag(1,4), x₀=0, b=(1,1).
Residuo
r₀=(1,1).Producto
Ar₀=(1,4).Independencia
El determinante de las dos columnas es tres; K₂=ℝ².
Dos direcciones bastan para representar cualquier candidato en este ejemplo.
Falta elegir cuál es el mejor en el espacio.
Cuatro generadores no siempre dan dimensión cuatro
A=2I y r₀≠0.
Productos
Ar₀=2r₀, A²r₀=4r₀ y A³r₀=8r₀.Span
Todos están en la misma recta.
Dimensión
K₄ tiene dimensión uno, con cuatro vectores en su lista generadora.
Contar la lista y calcular el rango son tareas diferentes.
En este caso el problema se resuelve dentro de esa recta.
3. CG minimiza una energía cuando A es simétrica positiva definida
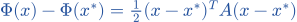 .
CG elige  que minimiza esa norma de error A sobre x₀+.
 ᵀAp_j=0 si i≠j.
No tienen por qué ser ortogonales euclídeamente. La propiedad se garantiza aquí para SPD y aritmética exacta.
Comprobar positividad
A=diag(1,4).
Forma
vᵀAv=v₁²+4v₂².Signo
Es positiva para cualquier vector no nulo.
Energía
∥v∥A=√(v₁²+4v₂²).
La segunda componente pesa más en esta norma.
No se usa la norma euclídea sin tener en cuenta la matriz.
Conjugadas y no perpendiculares
p=(1,1), q=(4,−1) y A=diag(1,4).
Euclídeo
pᵀq=4−1=3.Con A
Aq=(4,−4).Producto
pᵀAq=4−4=0.
La geometría relevante cambia con A.
Conjugación no significa que los segmentos formen noventa grados en un dibujo euclídeo.
4. Las recurrencias calculan cada paso sin reiniciar toda la búsqueda
Mientras  ≠0, usa
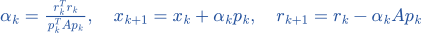 . El denominador es positivo para una dirección no nula por SPD.
Si el nuevo residuo es cero se termina.
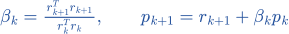 .
En dimensión n, CG termina en a lo sumo n pasos exactos. Con redondeo puede perder ortogonalidad; esa cifra no es un límite práctico garantizado.
Primer paso completo
A=diag(1,4), b=(1,1) y x₀=0.
Dirección
r₀=p₀=(1,1); p₀ᵀAp₀=5 y r₀ᵀr₀=2.Paso
α₀=2/5 y x₁=(2/5,2/5).Nuevo residuo
r₁=(1,1)−(2/5)(1,4)=(3/5,−3/5).
El nuevo residuo es ortogonal al anterior: su producto vale cero.
Aún no es la solución, porque r₁≠0.
Segundo paso y comprobación
Continuamos el mismo sistema.
Dirección
β₀=9/25 y p₁=(24/25,−6/25).Paso
p₁ᵀAp₁=144/125 y r₁ᵀr₁=18/25; α₁=5/8.Llegada
x₂=x₁+(5/8)p₁=(1,1/4); Ax₂=(1,1).
El sistema está resuelto tras dos pasos exactos.
Se detiene antes de intentar dividir por la norma de un residuo ya nulo.
5. La condición da una garantía y los autovalores dan más información
Una cota clásica de CG es 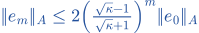 . Es una cota superior, no la trayectoria exacta del error.
Si A tiene pocos autovalores distintos, un polinomio de bajo grado puede anular todas las componentes del error. El agrupamiento espectral puede favorecer convergencia más rápida que la cota extrema. Para matrices no normales no se traslada este análisis como si todas fueran SPD.
Leer la cota
κ=9 y m=3.
Raíz
√κ=3.Cociente
(3−1)/(3+1)=1/2.Cota
∥e₃∥A≤2·(1/2)³∥e₀∥A=(1/4)∥e₀∥A.
La garantía reduce el error a como máximo una cuarta parte.
El error real podría ser mucho menor o cero.
Muchos tamaños, solo dos autovalores
A es diagonal con entradas uno o cuatro.
Polinomio
p(λ)=(1−λ)(1−λ/4) cumple p(0)=1.Anular
p(1)=p(4)=0.Consecuencia
En aritmética exacta CG puede eliminar el error en a lo sumo dos pasos, aunque haya muchas componentes.
La dimensión n no cuenta toda la historia.
Se conservan las hipótesis SPD y los valores espectrales exactos.
6. GMRES minimiza el residuo en lugar del error de energía
Para sistemas generales invertibles, GMRES usa Arnoldi para construir una base ortonormal del espacio de Krylov. Resuelve un pequeño problema de mínimos cuadrados y elige el candidato con menor ∥b−Ax∥₂ en ese espacio afín.
Almacenar y ortogonalizar todos los vectores cuesta cada vez más. GMRES reiniciado limita la memoria, pero puede perder convergencia o estancarse. CG y GMRES pueden dar puntos distintos incluso sobre una matriz SPD porque minimizan cantidades distintas.
Comparar el primer paso
Mismo A=diag(1,4), b=(1,1) e inicio cero; x=α(1,1).
Residual
Su cuadrado es (1−α)²+(1−4α)².
Minimizar
Derivar da −10+34α=0, luego α=5/17.Comparar
CG escogió 2/5: no son iguales.
GMRES minimiza aquí el residual euclídeo.
CG mantiene su garantía diferente de mínimo de energía.
Cuantificar la diferencia
Primeros residuos de ese ejemplo.
GMRES
r=(12/17,−3/17); norma cuadrada 9/17.CG
r=(3/5,−3/5); norma cuadrada 18/25.Comparar
9/17<18/25, aunque ambos usan la misma recta de candidatos.
El mínimo residual no tiene por qué coincidir con el mínimo error en norma A.
Una norma de error pequeña y un residual pequeño se relacionan mediante A.
7. PCG respeta la simetría mediante un cambio de variables
Escogemos M SPD y barato de resolver.
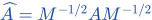 es SPD.
PCG implementa esa geometría usando z=M⁻¹r mediante resoluciones con M, sin necesitar formar la raíz o una inversa densa.
M⁻¹A es similar a la matriz transformada, pero puede no ser simétrica euclídeamente. Por eso aplicar CG ordinario a una matriz transformada arbitrariamente y llamarla simétrica no justifica el algoritmo. Las recurrencias de PCG usan productos rᵀz y la estructura de M.
Una transformación que equilibra todo
A=M=diag(1,16).
Raíz inversa
M⁻¹ᐟ²=diag(1,1/4).Matriz
M⁻¹ᐟ²AM⁻¹ᐟ²=I.Geometría
Con z=(x₁,4x₂), x₁²+16x₂² se convierte en z₁²+z₂².
La condición del sistema transformado vale uno.
En esta diagonal aplicar M⁻¹ es barato.
No suponer simetría del producto izquierdo
A=[[2,1],[1,2]] y M=diag(2,1), ambas SPD.
Multiplicar
M⁻¹A=[[1,1/2],[1,2]].Comparar
Las entradas fuera de diagonal son distintas.
Equivalente simétrico
M⁻¹ᐟ²AM⁻¹ᐟ²=[[1,1/√2],[1/√2,2]], que sí es SPD.
La justificación viene de la transformación simétrica.
Un M positivo no garantiza por sí solo mejorar la condición: también importa su relación con A.
8. El objetivo práctico es reducir coste total, no solo iteraciones
M=A sería perfecto para la condición, pero resolver Mz=r puede ser el problema original. Un buen precondicionador combina construcción asequible, aplicación barata y mejora de convergencia. Jacobi, factorizaciones incompletas y multigrid explotan estructuras diferentes.
Con precondicionamiento izquierdo, GMRES minimiza un residual transformado. Con precondicionamiento derecho se conservan las ecuaciones originales en la minimización habitual. Hay que observar el residual que importa y contabilizar memoria, preparación y productos, además de iteraciones.
Comparar dos costes
Método A prepara en 100 unidades y usa diez iteraciones de cinco; B prepara en diez y usa treinta de cuatro.
A
100+10·5=150.B
10+30·4=130.Elegir
Para una sola resolución, B cuesta menos pese a más iteraciones.
Menos iteraciones no equivale siempre a menos tiempo total.
Con muchos términos derechos el coste de preparación puede amortizarse.
El residual transformado puede engañar si no se especifica
M=1000I y residual original r de norma uno.
Izquierda
M⁻¹r tiene norma 0,001.
Original
El fallo de Ax=b sigue teniendo norma uno.Comparación
La cifra solo se interpreta sabiendo qué norma y transformación se ha usado.
Se comprueba también el residual real del sistema original.
No se deduce precisión mil veces mayor por una simple escala.
9. La parada comprueba el sistema real y las hipótesis del método
Durante la iteración se actualiza r por recurrencias para ahorrar trabajo. El redondeo puede separarlo de b−Ax; recalcular el residual real permite comprobar la parada. Una tolerancia combina a menudo una parte absoluta y otra relativa al dato o al residuo inicial.
Si el problema requiere una cota de error, se incorpora la condición o una estimación específica. También se revisan simetría, positividad y compatibilidad del precondicionador. Terminar en n pasos exactos, conservar ortogonalidad o una cota de convergencia no son afirmaciones independientes de esas condiciones.
Aplicar una regla de parada
Se pide ∥r∥≤max(10⁻⁸,10⁻⁶∥b∥), con ∥b∥=100.
Parte relativa
10⁻⁶·100=10⁻⁴.Umbral
El máximo es 10⁻⁴.
Residuo
Con ∥r∥=5·10⁻⁵ se cumple esta regla.
La regla garantiza el residual indicado, no automáticamente un error relativo igual.
La condición conecta las dos afirmaciones.
Detectar una matriz fuera del marco de CG
A=diag(1,−1), dirección p=(1,1).
Producto
Ap=(1,−1).Denominador
pᵀAp=0.Fallo
La fórmula del paso puede dividir por cero; A no es positiva definida.
Antes de ejecutar se verifican las hipótesis del método.
La invertibilidad de esta matriz no la convierte en SPD.
Ahora lo resolvemos de principio a fin.
EJEMPLO RESUELTO 1
Condición diagonal
Calcula κ₂ de diag(1,100).
Leer la matriz
A=diag(1,100).Valores singulares
En esta diagonal positiva son uno y cien.
Máximo
La norma espectral de A vale cien.
Inversa
A⁻¹=diag(1,1/100), de norma espectral uno.Condición
κ₂(A)=100·1=100.Comprobar
También es el cociente entre autovalor máximo y mínimo porque A es SPD.
La condición espectral es 100.
La disparidad de escalas puede frenar métodos iterativos.
EJEMPLO RESUELTO 2
Precondición ideal
Para esa diagonal, usa M=diag(1,100). Calcula M⁻¹A.
Escoger el precondicionador
M=diag(1,100)=A.Aplicar inversa
Resolver Mz=r divide la segunda componente por cien.
Multiplicar
M⁻¹A=diag(1,1)=I.Condición
La identidad tiene condición uno.
Geometría
La transformación simétrica equivalente también es la identidad.
Coste
Aquí resolver con M es barato por ser diagonal; para una matriz general elegir M=A puede ser costoso.
M⁻¹A=I, de condición 1.
En este caso aplicar M⁻¹ es barato porque es diagonal.
Los símbolos que hemos usado
- r₀=b−Ax₀
- Residuo de la aproximación inicial.
- K_m(A,r₀)
- Span de r₀, Ar₀, …, A^(m−1) r₀.
- SPD
- Matriz real simétrica y definida positiva.
- ‖e‖_A
- Norma de energía √(eᵀAe), cuando A es SPD.
- κ₂(A)
- Condición en norma euclídea; para SPD es λ_max/λ_min.
- M
- Precondicionador cuya acción inversa se puede aplicar a coste razonable.
- GMRES
- Método que minimiza la norma euclídea del residuo sobre un espacio de búsqueda de Krylov.
Ahora te toca a ti.
Tienes cinco ejercicios. Inténtalos; las pistas te ayudan si te atascas.
Practicar este tema →