Las flechas no bastan para comprobar una independencia numérica. Necesitamos una distribución y una regla que diga qué información deja de cambiar la respuesta al conocer los padres. Vamos a traducir esa regla y a justificar las dos direcciones entre Markov local y el producto de tablas.
Si necesitas repasar:
1. Ser independiente significa que cierta información no cambia una distribución
X e Y son independientes si P(X=x,Y=y)=P(X=x)P(Y=y) para todos sus estados. Condicionar por Z=z significa fijar un grupo y comprobar la independencia dentro de él, cuando P(Z=z)>0.
No exige que las variables tengan el mismo valor, ni que carezcan de caminos en un dibujo. La independencia es una propiedad de P; el grafo especifica restricciones para las distribuciones compatibles con él.
La misma probabilidad en cada grupo
X e Y son bits independientes y equiprobables.
Conjunta
Cada par 00,01,10,11 tiene probabilidad 1/4.
Condicionar
P(X=1|Y=0)=(1/4)/(1/2)=1/2.Comparar
Con Y=1 también da 1/2, igual a P(X=1).
Conocer Y no cambia la distribución de X.
X e Y pueden coincidir o diferir; ninguna de esas dos cosas define por sí sola independencia.
Una igualdad de valores dependiente
Tomar X=Y, con ambos estados 0 y 1 de probabilidad 1/2.
Marginal
P(X=1)=1/2.Dato
Si conocemos Y=1, X=1 con probabilidad uno.Conclusión
La distribución cambió, de modo que no son independientes.
Una información útil modifica la respuesta.
Este ejemplo no depende de cómo dibujemos los nodos.
2. Separamos a los padres de los demás no descendientes
Para X, excluimos X mismo y todos sus descendientes. Entre los nodos que quedan, separamos los padres PA(X); llamamos R(X) al vector restante. Markov local exige 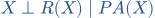 .
La independencia se refiere al vector completo R(X). Que X sea independiente de cada componente por separado no garantiza que sea independiente de la información que aportan juntas.
Construir los dos conjuntos
En U→T←V y T→W, buscar PA(T) y R(T).
Padres
U y V apuntan directamente a T.
Descendiente
W se alcanza desde T y queda excluido.
Resto
No queda otro nodo: PA(T)={U,V} y R(T)=∅.
La afirmación local de T no añade aquí una restricción no vacía.
La raíz U sí tiene como no descendiente relevante a V.
Por parejas no basta
A y D son bits independientes justos y C indica si son distintos.
Saber solo A
Con A fijo, D sigue justo y P(C=1|A)=1/2; lo mismo ocurre con D.
Saber los dos
Si A=0,D=0, entonces C=1 tiene probabilidad cero.Comparar
C es independiente de cada bit por separado, pero no del vector (A,D).
La información conjunta puede revelar lo que cada dato aislado oculta.
Si B es constante, el mismo ejemplo demuestra el fallo de sustituir independencia vectorial por parejas dado B.
3. En la hoja C, conocer B hace sobrantes A y D para su distribución
Markov local se lee 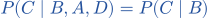 sobre condiciones de probabilidad positiva.
Eso no afirma C⊥D sin conocer B. Pueden depender marginalmente porque comparten el estado de B. La condición pide que A y D juntos no añadan información sobre C después de conocer B.
Un padre común puede crear dependencia marginal
B es un bit justo y ponemos C=B,D=B.
Sin observar B
P(C=1)=P(D=1)=1/2, pero P(C=1,D=1)=1/2, no 1/4.Con B
Si B=b, C y D quedan fijos en b: sus condicionales factorizarán.Interpretar
Hay independencia condicionada aunque no marginal.
No se elimina la condición B de la afirmación.
Los valores cero y uno en las tablas no invalidan el ejemplo.
Traducir una fila concreta
Si P(C=Sí|B=No)=0,3, ¿qué añade saber A y D?
Hipótesis
Suponemos que la conjunta satisface Markov local para este grafo.
Condición válida
Para cualquier A=a,D=d con P(B=No,A=a,D=d)>0, la igualdad se aplica.Respuesta
P(C=Sí|B=No,A=a,D=d)=0,3.
El valor queda en la fila de B=No.
No se evalúa una condicional por cociente sobre una condición de probabilidad cero.
4. Probabilidad cero no prohíbe el teorema; sí prohíbe dividir por cero
En un DAG discreto finito, la equivalencia de Markov local y factorización admite ceros. Las igualdades condicionadas se leen solo en el soporte: no definimos P(X|Z=z) como una razón si P(Z=z)=0.
Una configuración parental imposible puede completarse con cualquier fila válida de CPT; la conjunta no identifica esa fila. Para que el producto reconstruya P en la dirección de Markov, las filas deben coincidir con sus condicionales donde estas existen.
Una fila no identificada
A=0 siempre y A→S.
Condición posible
La fila S dado A=0 sí afecta a la conjunta.Condición imposible
P(A=1)=0, así P(S|A=1) no se obtiene dividiendo por esa marginal.
Completar
Elegir allí (0,2;0,8) o (0,9;0,1) deja las conjuntas con A=1 en cero.
Las dos CPT pueden representar la misma conjunta.
No significa que podamos cambiar libremente filas sobre condiciones posibles.
Un cero individual con denominador positivo
P(A=0)=1 y P(S=1|A=0)=0.
Conjunta
P(A=0,S=1)=1·0=0.Condición
P(A=0)=1 es positivo.Cociente
P(S=1|A=0)=0/1=0 está bien definido.
Numerador cero y denominador cero son situaciones distintas.
Markov local no exige que una observación imposible reciba una posterior arbitraria.
5. De Markov a factorización: quitamos antecedentes que no son padres
Partimos de P y un DAG finito que satisface Markov local.
Los anteriores no pueden ser descendientes de xᵢ.
Markov permite quitar los anteriores que no sean padres.
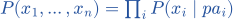 .
Con ceros, se justifica la igualdad por configuraciones en soporte y el primer prefijo imposible; no se divide por ese prefijo.
Hacer visible el recorte
Usar A,B,C,D como orden.
Cadena
P(A)P(B|A)P(C|A,B)P(D|A,B,C).
Markov
C permite quitar A; D permite quitar A y C.
Producto
P(A)P(B|A)P(C|B)P(D|B).
Cada nodo conserva sus padres y un solo factor.
No quitamos B de los factores de C y D.
Por qué también funciona un estado imposible
Recorrer un estado completo cuya probabilidad es cero.
Primer fallo
Hay un primer prefijo imposible, precedido por uno de probabilidad positiva.
Factor
La probabilidad del siguiente estado dado ese prefijo anterior vale cero; Markov la identifica con su factor parental.
Producto
Aparece un factor cero, de modo que el producto completo también es cero.
No hace falta definir cocientes condicionados por un prefijo ya imposible.
Las filas parentales imposibles se completan normalizadas sin alterar esta igualdad.
6. De CPT a una conjunta: sumamos las hojas hasta llegar a uno
Ahora el punto de partida cambia: tenemos un DAG y una fila válida para cada condición de cada nodo. Definimos P como producto de esas entradas. Todos los productos son no negativos.
Para sumar toda la conjunta eliminamos primero una hoja. Su estado solo aparece como variable de su propio factor, y al sumarlo ese factor vale uno. Repetimos en el grafo restante hasta las raíces. La distribución resultante satisface Markov local; puede tener independencias adicionales.
Normalizar una cadena con ceros permitidos
En A→S, tomar cualquier raíz válida y cualquier CPT válida.
Escribir
La suma total es ΣₐP(a)ΣₛP(s|a).
Dentro
Para cada a, la suma de su fila de S es uno, incluso si tiene entradas cero.
Fuera
Queda ΣₐP(a)=1.
Las filas válidas bastan para normalizar este DAG.
No hay que dividir los productos por una constante correctora.
Ver Markov después de sumar descendientes
Para un nodo X, eliminar primero todos sus descendientes.
Eliminar
Sumar en orden inverso topológico sus estados elimina sus CPT con factores uno.
Restante
La marginal sobre X y sus no descendientes tiene forma θ(X|PA(X)) por un factor que no depende de X.
Condicionar
En condiciones positivas, al normalizar sobre X ese otro factor se cancela y queda θ(X|PA(X)).
El resto de no descendientes no cambia la distribución de X dados sus padres.
Los descendientes solo reciben padres dentro de los nodos restantes o de los propios descendientes, lo que permite la eliminación.
7. El grafo garantiza independencias, no todas las dependencias posibles
Una raíz sin padres también tiene condición local: debe ser independiente de sus no descendientes relevantes. En U→T←V, las raíces U y V son independientes en toda distribución que factorice así, aunque observar T puede volverlas dependientes.
Una flecha puede resultar redundante si las filas del hijo son iguales. Tampoco se extiende el argumento de normalización a grafos con ciclos: ya no podemos eliminar siempre una hoja. Las afirmaciones probabilísticas no implican por sí mismas causalidad.
Una flecha que no cambia las probabilidades
A→S, con P(S=Sí|A=Sí)=P(S=Sí|A=No)=0,4.
Factor
La tabla de S no depende del estado a.
Conjunta
P(A=a,S=s)=P(A=a)P(S=s).Conclusión
A y S son independientes aunque la flecha esté dibujada.
La estructura admite dependencias que ciertos parámetros no usan.
Ausencia de una independencia gráfica no prueba dependencia numérica.
Un producto cíclico que suma dos
Dos bits A↔B: cada tabla impone que el hijo sea igual al padre.
Estados iguales
El producto P(A|B)P(B|A) vale uno en 00 y en 11.
Distintos
En 01 y 10 vale cero.
Suma
1+0+0+1=2, aunque cada fila de cada tabla suma uno.
La garantía anterior usa aciclicidad.
Normalizar este producto por dos sería otra construcción; no justifica aplicar el teorema de DAG.
8. Leemos las hipótesis antes de elegir una dirección
Si nos dan una conjunta P y la condición local, justificamos su producto por la regla de la cadena y el orden topológico. Si nos dan tablas válidas, construimos P y justificamos su normalización y Markov.
Los números de teorema cambian entre apuntes. Conviene conservar el enunciado: qué datos tenemos, qué hipótesis comprobamos y qué conclusión está permitida. La inferencia usará después esa conjunta para sumar estados y condicionar.
Un enunciado que entrega tablas
Se dan un DAG finito y todas sus CPT normalizadas.
Tenemos
No necesitamos una conjunta previa: el producto la define.
Garantía
La suma de productos es uno y satisface Markov local.
Siguiente
Podemos marginalizar o condicionar si la evidencia tiene probabilidad positiva.
Es la dirección construcción desde tablas.
Una fila ausente o inválida impediría usar esa garantía.
Un enunciado que entrega una distribución
Se da P y se sabe que cumple Markov en A→B→C.
Cadena
P(A,B,C)=P(A)P(B|A)P(C|A,B).Hipótesis
Markov de C permite sustituir P(C|A,B) por P(C|B) en soporte.
Conclusión
P(A,B,C)=P(A)P(B|A)P(C|B), completando filas imposibles si hace falta.
Es la dirección representación de una P compatible.
No afirmamos que cualquier P satisfaga la independencia que necesita ese grafo.
Ahora lo resolvemos de principio a fin.
EJEMPLO RESUELTO 1
Traducir Markov para una hoja
En A → B, B → C y B → D, escribe la condición local de Markov de C y explica qué información puede quitarse al conocer B.
Fijar el nodo
La consulta local se refiere a C.
Padres
PA(C)={B}.Descendientes
C es hoja y no tiene descendientes.
Resto
Quitamos C y su padre B: R(C)={A,D}.Traducir
C⊥(A,D)|B: dados los padres, el vector adicional no cambia su distribución.
Alcance
La igualdad se lee en soporte y no elimina la condición B.
C ⟂ (A, D) | B.
Condicionar solo por A no es la misma afirmación: el conjunto de padres que exige Markov es B.
EJEMPLO RESUELTO 2
Un producto para una configuración completa
En el mismo DAG, para una configuración concreta se leen P(A=a)=0,5, P(B=b | A=a)=0,8, P(C=c | B=b)=0,3 y P(D=d | B=b)=0,6. Calcula su probabilidad conjunta.
Producto correcto
P(A=a,B=b,C=c,D=d)=P(a)P(b|a)P(c|b)P(d|b).Leer datos
Los cuatro factores dados son 0,5;0,8;0,3;0,6.
Primer producto
0,5·0,8=0,4.Siguiente
0,4·0,3=0,12.Último
0,12·0,6=0,072.Control
La configuración es más restrictiva que A=a,B=b, por lo que 0,072≤0,4 es coherente.
La probabilidad conjunta de esa configuración es 0,072.
Es no negativa y no supera 0,4, la probabilidad de la configuración menos restrictiva A=a, B=b.
Los símbolos que hemos usado
- PA(X)
- Vector de padres de X.
- R(X)
- Los demás no descendientes: excluimos X y los padres que ya estamos condicionando.
- X ⟂ R(X) | PA(X)
- Conocidos los padres, añadir ese vector de no descendientes no cambia la distribución de X.
- ∏
- Producto: multiplicar un factor por cada nodo.
- θᵢ(xᵢ | paᵢ)
- Entrada de la tabla del nodo i para esos estados del nodo y de sus padres.
- ∅
- Conjunto vacío: una raíz no tiene padres que condicionar.
Ahora te toca a ti.
Tienes cinco ejercicios. Inténtalos; las pistas te ayudan si te atascas.
Practicar este tema →